DeepSeek-V4.1-Flash, expliqué pas à pas
Comment DeepSeek a divisé par quatre la mémoire nécessaire pour retenir un long contexte, et par huit la mémoire à conserver entre deux requêtes, tout en obtenant un modèle meilleur que son prédécesseur. On part des bases, puis on démonte chaque innovation avec des schémas manipulables et les figures originales du papier.
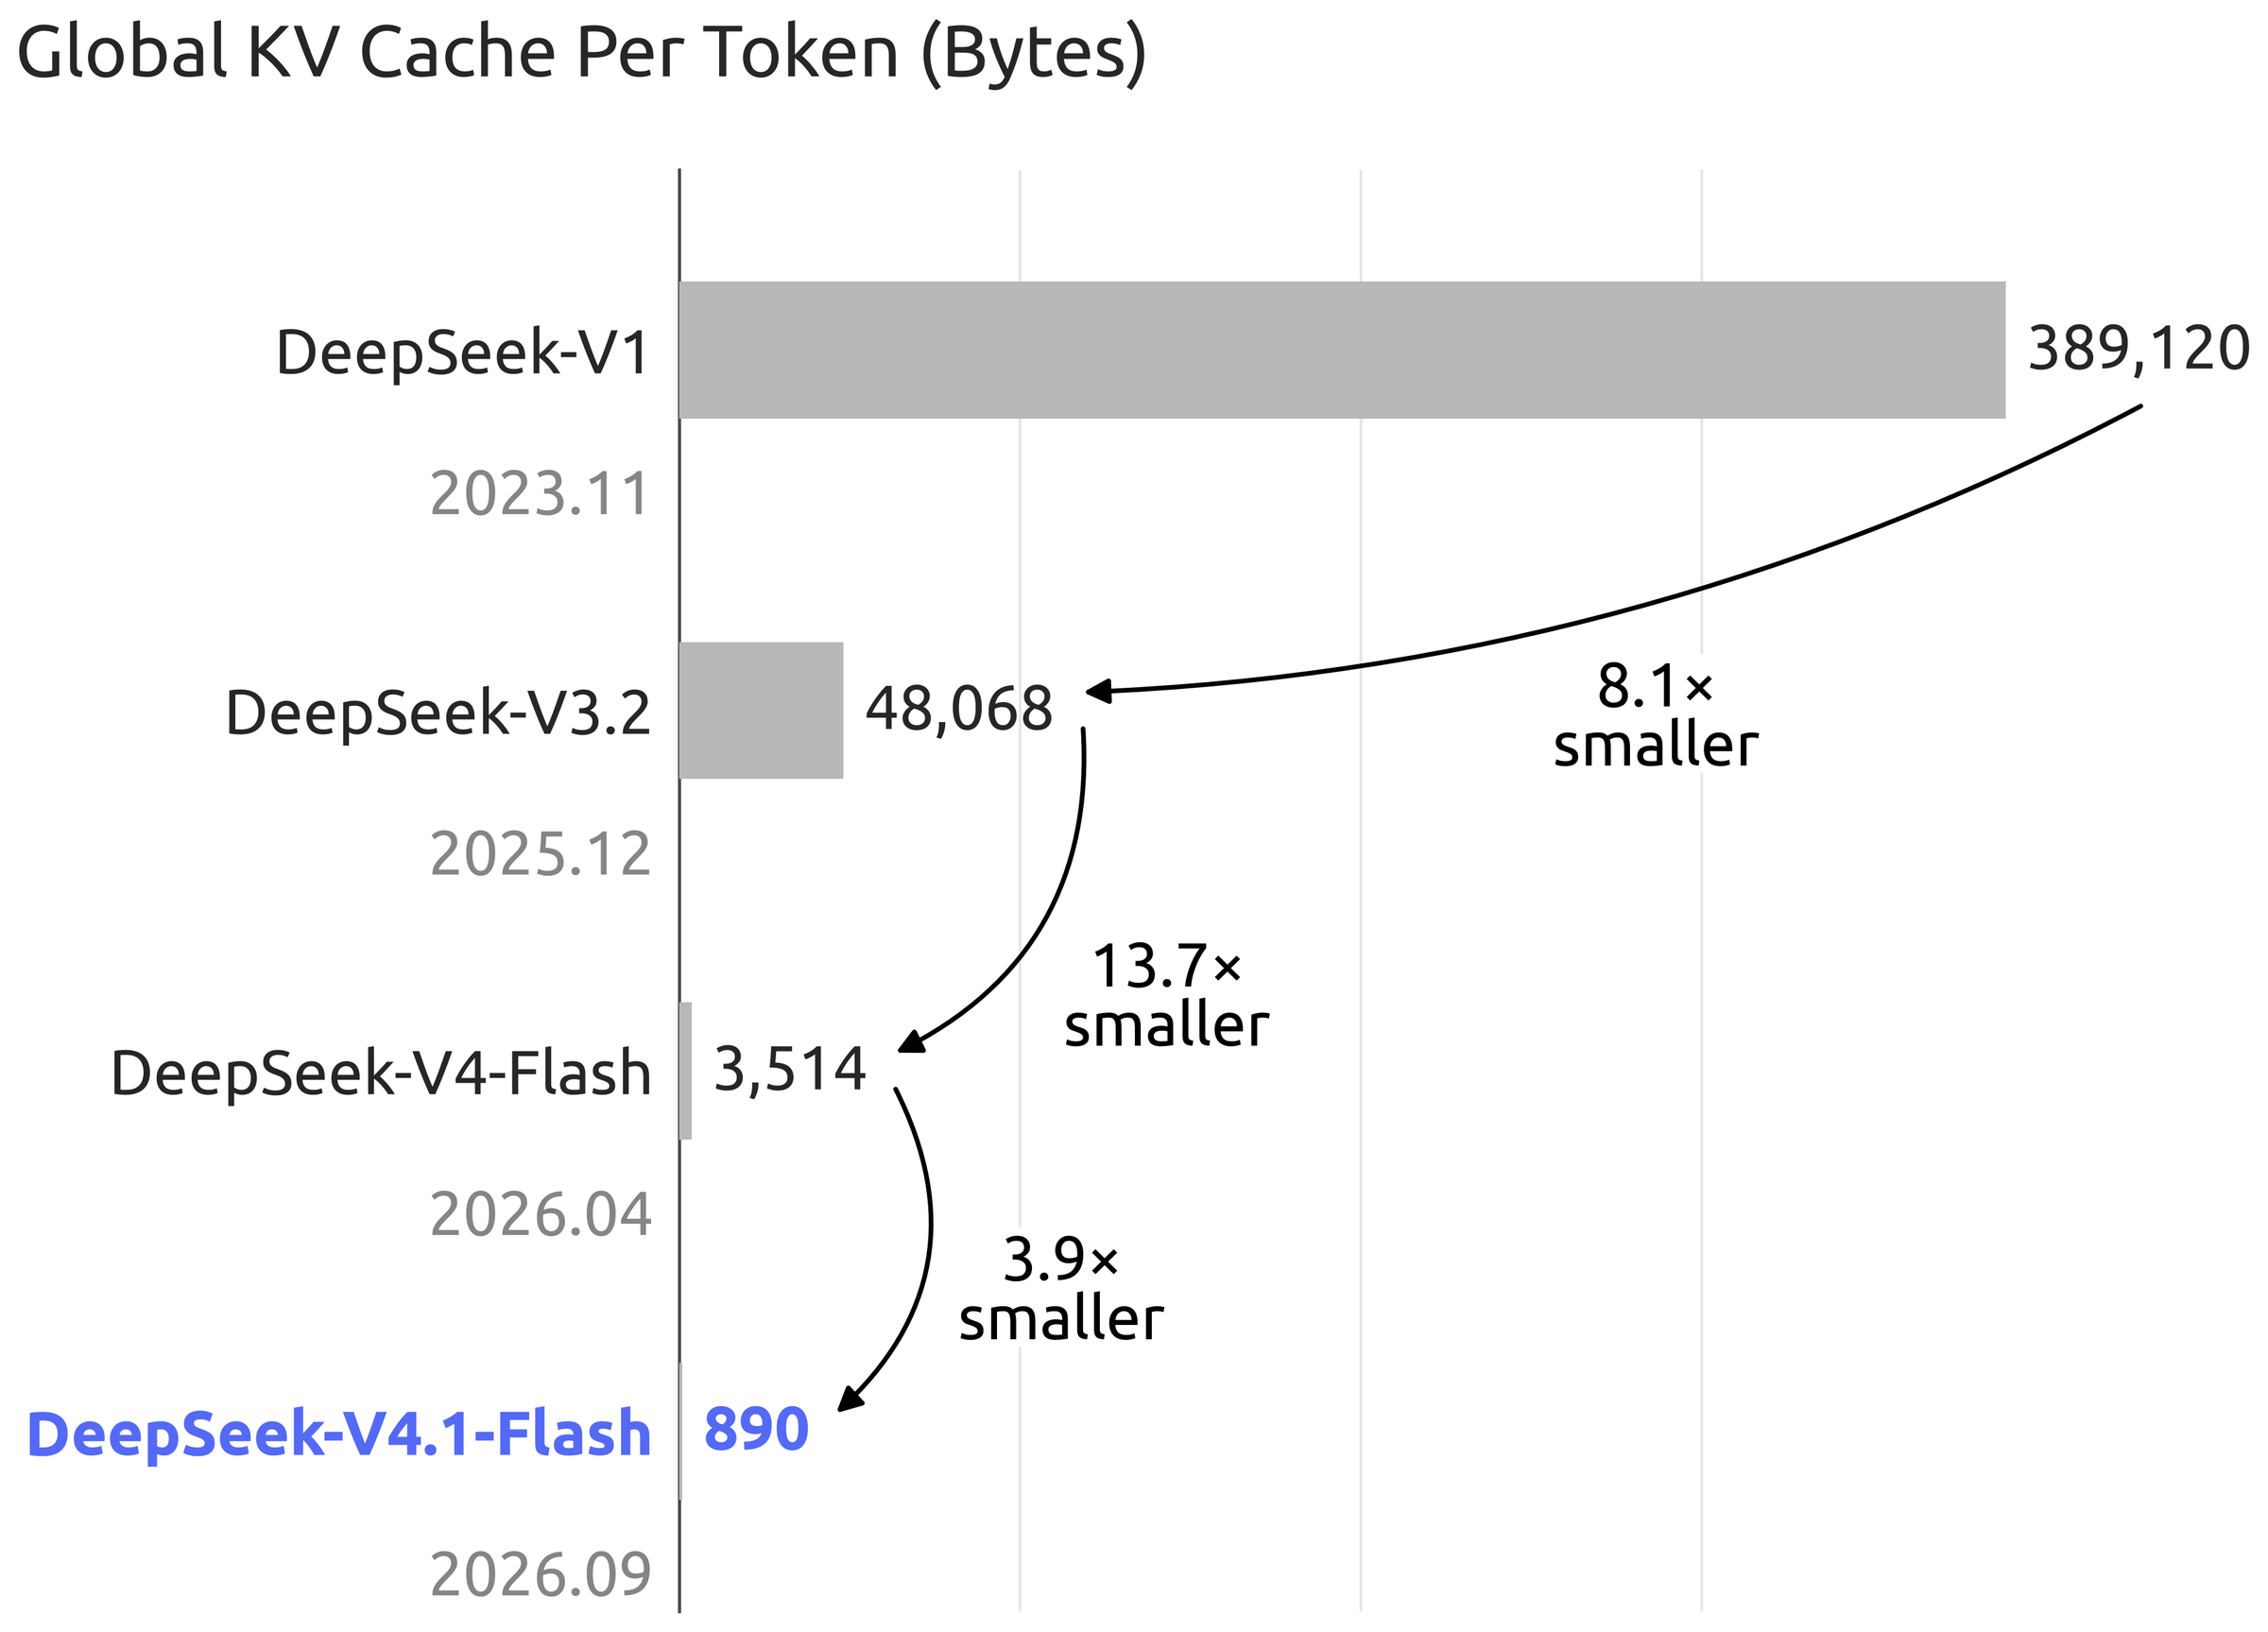
Taille du cache KV global, en octets par token
Les bases en dix minutes
Avant d'attaquer le papier, on remet en place les six notions sans lesquelles rien ne sera clair : le token, les deux phases prefill et decode, l'attention, le cache KV, le mélange d'experts et les différentes formes d'attention. Si vous connaissez déjà tout ça, passez au chapitre 2.
- Pourquoi un modèle garde en mémoire les clés et valeurs de tout ce qu'il a lu
- La différence entre prefill (lire) et decode (écrire), et pourquoi les agents saturent le prefill
- Ce que signifient « 8 Md de paramètres activés » dans un modèle de 552 Md
1.1 Un modèle de langage écrit un token à la fois
Un LLM ne manipule pas des mots mais des tokens. Son unique talent : à partir d'une séquence de tokens, prédire le suivant. Pour écrire une réponse, il prédit un token, l'ajoute à la séquence, puis recommence. C'est la génération autorégressive.
Ce travail se déroule en deux phases très différentes :
- Le prefill : le modèle lit tout le prompt d'un coup. Tous les tokens sont traités en parallèle, ce qui fait de grosses multiplications de matrices. Cette phase est limitée par la puissance de calcul.
- Le decode : le modèle produit la réponse un token à la fois. À chaque pas, il ne calcule qu'un token, mais doit relire tous ses poids et toute sa mémoire du contexte. Cette phase est limitée par la bande passante mémoire.
1.2 L'attention : chaque token interroge les précédents
Pour prédire la suite, chaque token a besoin d'informations venant des tokens précédents. C'est le rôle de l'attention. Chaque token produit trois vecteurs :
- une requête Q (query) : « qu'est-ce que je cherche ? » ;
- une clé K (key) : « voici ce que je contiens », comme l'étiquette d'un tiroir ;
- une valeur V (value) : le contenu du tiroir, l'information réellement transmise.
Le token courant compare sa requête à toutes les clés (produit scalaire). Il transforme ces scores en poids qui somment à 1 (softmax), puis fait la moyenne pondérée des valeurs. Un modèle empile des dizaines de couches qui répètent cette opération. DeepSeek-V4.1-Flash en a 40.
1.3 Le cache KV : la mémoire du contexte
Dans un modèle causal, un token ne regarde jamais le futur. Les clés et valeurs d'un token passé ne changent donc plus jamais. Plutôt que de les recalculer à chaque nouveau token, on les stocke : c'est le cache KV. Il grandit linéairement avec la longueur du contexte :
Ce cache vit à trois étages de mémoire, du plus rapide et rare au plus lent et abondant :
HBM du GPU
Mémoire collée au processeur graphique, ultra-rapide mais de quelques dizaines à centaines de Go. Le cache des requêtes en cours y réside. C'est la ressource la plus chère.
RAM de l'hôte (DRAM)
La mémoire du serveur, plus grande et plus lente. V4.1 y place un petit cache à durée de vie courte, de l'ordre de quelques minutes (chapitre 8).
SSD
Stockage massif mais lent. On y conserve le cache persistant, qui permet de réutiliser un préfixe déjà lu plusieurs heures ou jours plus tard (au moins 72 h chez DeepSeek).
1.4 Pourquoi les agents changent tout
Un agent (assistant de code, automatisation de bureau…) enchaîne des dizaines d'appels d'outils. À chaque tour, la sortie de l'outil (un fichier, un log, une page web) s'ajoute au contexte. Le modèle doit la lire (prefill), puis écrire quelques lignes (decode). Résultat : les charges de travail deviennent très majoritairement en entrée (input-heavy).
Deux mécanismes permettent de tenir le coût :
- Le cache de préfixe : si le début du contexte a déjà été lu, on recharge son cache KV au lieu de le recalculer. Il faut alors stocker ce cache, parfois longtemps, sur SSD.
- Un prefill moins cher : pour les nouveaux tokens, et pour les cas où le cache a été perdu (cache miss), il faut tout recalculer.
1.5 Le mélange d'experts (MoE) : beaucoup de paramètres, peu d'activés
Dans un Transformer, chaque couche alterne attention et réseau « feed-forward ». Dans un modèle MoE, ce réseau est découpé en nombreux petits experts. Un routeur n'en active que quelques-uns par token. DeepSeek-V4.1-Flash utilise dans chaque couche 1 expert partagé (toujours actif) et 384 experts routés, dont 6 sont choisis pour chaque token.
C'est pourquoi on distingue paramètres totaux (552 Md, la connaissance stockée) et paramètres activés (le calcul réellement fait pour un token). Particularité de V4.1 : ce second chiffre vaut 8 Md en prefill et 16 Md en decode. Le chapitre 4 explique pourquoi.
1.6 Trois façons de regarder le passé
Un contexte d'un million de tokens pose un problème : si chaque nouveau token compare sa requête à un million de clés, dans chaque couche, le coût explose. La famille DeepSeek combine donc plusieurs formes d'attention :
- L'attention globale dense regarde tout le passé. Elle est exacte mais son coût croît avec la longueur.
- L'attention à fenêtre glissante (SWA) ne regarde que les nwin = 128 derniers tokens. Son coût et son cache sont bornés.
- L'attention parcimonieuse (sparse) : un petit module, l'indexeur, note toutes les entrées du passé et n'en garde que les 512 meilleures (top-k). L'attention principale ne lit que celles-là, plus la fenêtre locale.
DeepSeek-V3.2 et V4 ont introduit ces attentions parcimonieuses et compressées. Le décor de V4.1 est donc : une branche locale (SWA) dans chaque couche + une branche globale compressée et parcimonieuse.
La mémoire du contexte, le cache KV, grandit avec chaque token lu. Les agents lisent énormément : ils paient cher le prefill (lecture) et le stockage du cache. Toutes les innovations de V4.1 attaquent l'un ou l'autre de ces coûts.
Le problème : la mémoire du contexte coûte plus cher que le calcul
Les générations précédentes ont déjà rendu le calcul du long contexte abordable grâce à l'attention parcimonieuse. Le nouveau goulot d'étranglement, disent les auteurs, c'est le stockage et le déplacement du cache KV.
Dans DeepSeek-V4, chaque couche combine deux branches d'attention :
- une branche globale qui couvre tout le contexte. Elle maintient un KV global, composé du main KV (les entrées lues par l'attention) et de l'indexer K (les clés de l'indexeur qui choisit les entrées à lire) ;
- une branche locale SWA qui maintient le KV SWA des 128 derniers tokens.
Le KV SWA a une taille fixe, quelle que soit la longueur du contexte. Pour les longues séquences, c'est donc le KV global qui domine la mémoire. Il est limité par la capacité de la HBM. De plus, une partie du cache est persistée sur SSD ou en RAM hôte pour réutiliser les préfixes, ce qui ajoute deux contraintes : la capacité de stockage et la bande passante d'entrée/sortie.
Ensemble, ces contraintes de calcul, de stockage et de bande passante forment selon les auteurs « le principal goulot d'étranglement » pour baisser encore les coûts de déploiement, et freinent l'adoption des agents sur des tâches plus longues.
Trois leviers, combinés
Le papier présente la compression comme le fruit d'une optimisation conjointe à trois niveaux. Chacun fait l'objet d'un chapitre de ce cours :
CED + CSA2
L'encodeur-décodeur causal (CED) fabrique le KV global du décodeur à partir de l'encodeur. CSA2 partage ce KV entre couches au lieu d'en garder un par couche.
→ chapitres 4, 5, 6
Cache principal en FP4
Chaque nombre du cache principal est stocké sur 4 bits au lieu de 8, avec un facteur d'échelle pour 16 valeurs. Le modèle est entraîné pour le supporter (QAT).
→ chapitre 7
SWA Bounded Replay
Le KV local (SWA) n'est plus stocké durablement. S'il manque, on le reconstruit approximativement en rejouant seulement 128 tokens.
→ chapitre 8
Bilan annoncé : à longueur de séquence égale, V4.1-Flash n'a besoin que d'environ ¼ du cache KV d'exécution (en HBM) et d'environ ⅛ du cache KV persistant (SSD / RAM hôte) de V4-Flash. C'est pourtant un modèle plus gros (552 Md contre 284 Md de paramètres) et plus performant.
Et le calcul du decode ?
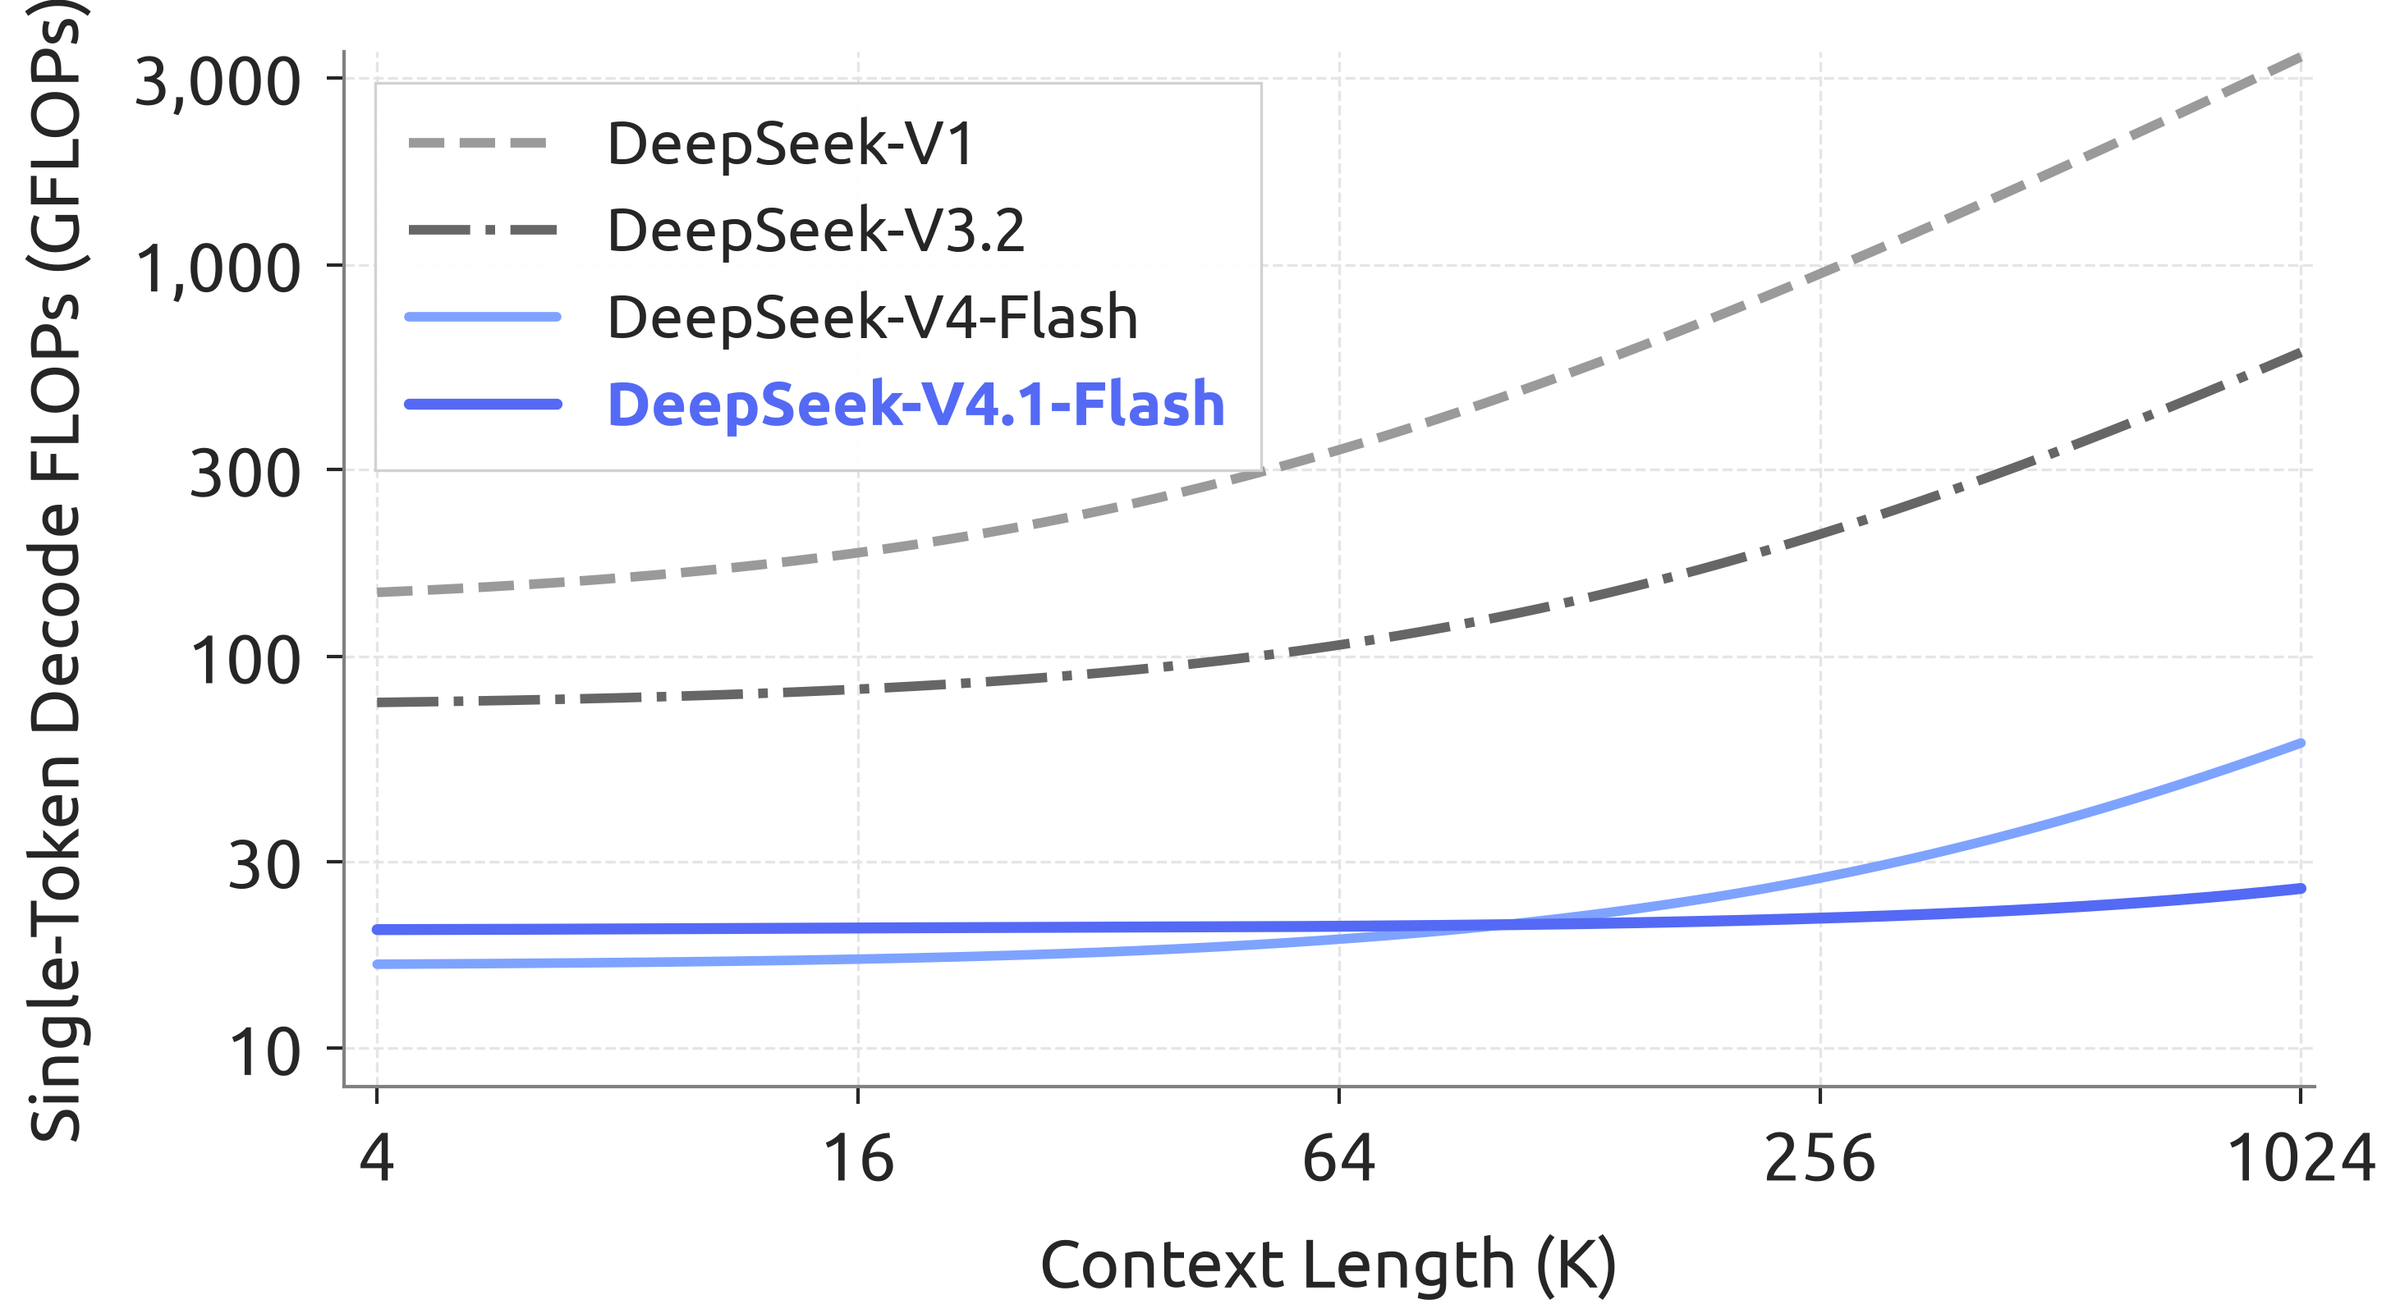
Toutes les améliorations se combinent aussi côté calcul. La figure 2 compte les opérations nécessaires pour générer un token selon la longueur du contexte déjà présent. Elle pondère les opérations BF16, FP8 et FP4 par 1, 0,5 et 0,25. Pour V4.1-Flash, la courbe est presque plate : multiplier le contexte par 256, de 4K à 1M tokens, n'augmente le coût d'un token que d'un quart.
Le KV global (main KV + indexer K) domine la mémoire des longs contextes. V4.1 le réduit à 890 octets par token grâce à trois leviers : l'architecture (CED + CSA2), la précision (FP4) et le déploiement (SWA Bounded Replay).
Vue d'ensemble de l'architecture
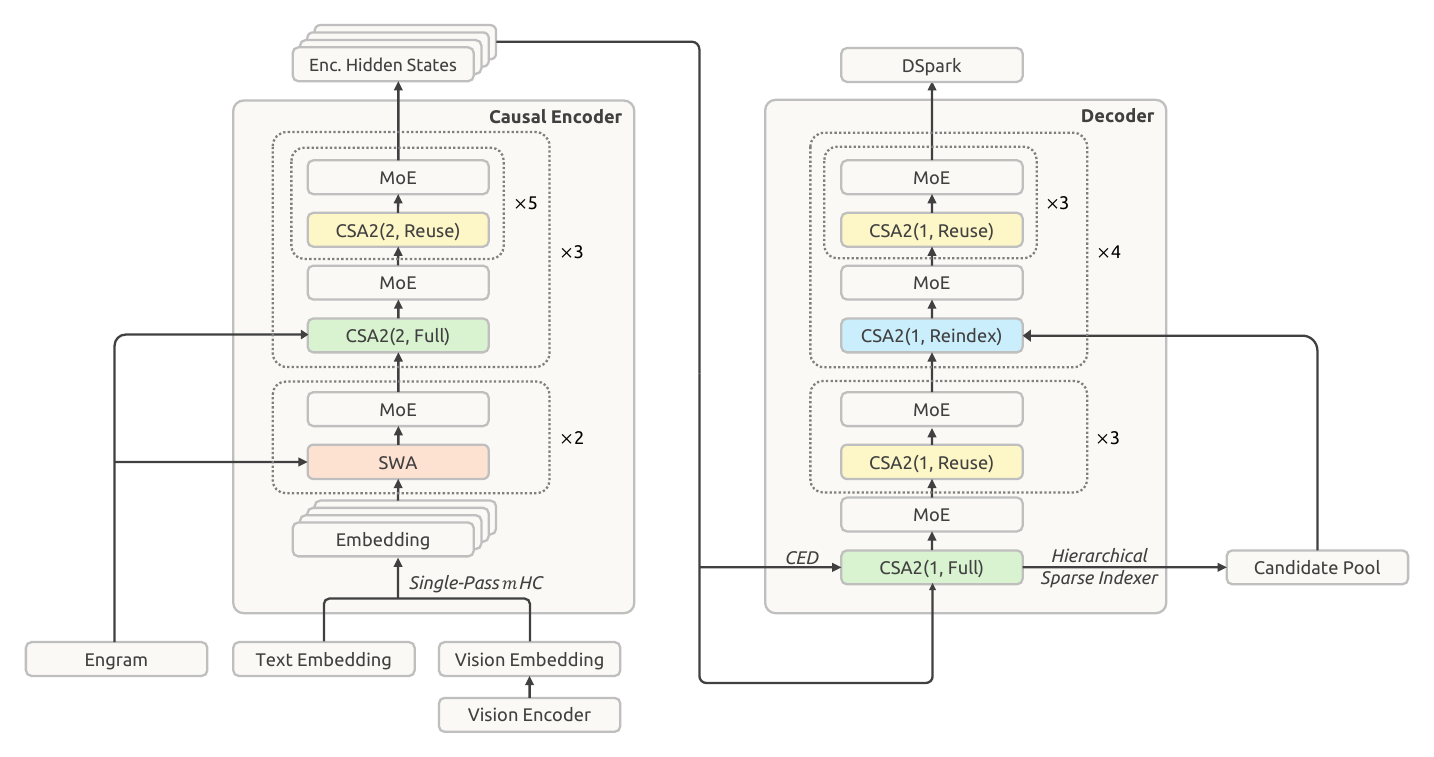
DeepSeek-V4.1-Flash est un Transformer à mélange d'experts, multimodal (texte + images en entrée, texte en sortie), avec 40 couches coupées en deux moitiés aux rôles bien distincts.
Voici la carte générale avant d'entrer dans les détails :
- 40 couches Transformer causales, organisées en un encodeur causal de 20 couches suivi d'un décodeur de 20 couches. Le mot « encodeur » peut surprendre : ici, il reste causal (il ne regarde jamais le futur). Il est simplement la moitié basse du réseau.
- Chaque couche combine une attention globale (CSA2) et une attention locale SWA, sauf les deux premières, en SWA seule.
- Toutes les couches feed-forward sont des DeepSeekMoE standard.
- Un encodeur visuel (DeepSeek-ViT) et un projecteur MLP transforment les images en embeddings traités avec le texte dès le début du pré-entraînement.
- S'y ajoutent quatre briques : Single-Pass mHC (les connexions résiduelles), Engram (une mémoire consultable par hachage), DSpark (décodage spéculatif) et l'indexeur parcimonieux hiérarchique.
Les hyperparamètres clés
Pour les curieux, voici la configuration donnée dans la section 4.2.1 du rapport. Pas besoin de tout retenir : on reviendra sur chaque chiffre important au fil des chapitres.
| Élément | Valeur |
|---|---|
| Couches / dimension cachée d | 40 couches (20 encodeur + 20 décodeur), d = 5 120 |
| Attention principale | 64 têtes de requête de dimension 512 ; compression des requêtes à 1 280 ; 8 groupes de projection de sortie de dimension 1 024 |
| Indexeur | 32 têtes de requête de dimension 128 ; top-k = 512 entrées lues par l'attention |
| Compression CSA2 | m = 2 dans l'encodeur, m = 1 (pas de compression) dans le décodeur |
| Fenêtre SWA | nwin = 128 tokens |
| Indexeur hiérarchique | au plus 2 048 blocs de 8 positions, soit 16 384 candidats |
| MoE | 1 expert partagé + 384 experts routés (6 activés par token), dimension intermédiaire 2 304, SwiGLU borné (clamp) à 10 |
| mHC | facteur d'expansion 4 (4 flux résiduels), 20 itérations de Sinkhorn-Knopp |
| Engram | 196 Md de paramètres répartis sur 2 modules (couches 1 et 14, indexées à partir de 0) |
| Vision | ViT de 32 couches, dimension 1 024, 16 têtes, patchs de 14 px ; projecteur MLP de 2 couches |
| Paramètres | 552 Md (backbone) ; 8 Md activés par token en prefill, 16 Md en decode |
V4 mélangeait deux types d'attention compressée (CSA et HCA). V4.1 n'utilise plus que CSA2. Le module de prédiction multi-token (MTP) utilisé pendant le pré-entraînement de V3/V4 est retiré ; DSpark, entraîné séparément après le pré-entraînement, prend en charge le décodage spéculatif.
CED : l'encodeur-décodeur causal qui coupe le prefill en deux
Première grande idée du papier : le Causal Encoder-Decoder. Il fait sauter la moitié haute du réseau à presque tous les tokens du prompt, sans perdre en qualité.
- Comment le décodeur obtient son KV global sans calculer ses propres couches
- Pourquoi l'attention locale (SWA) complique les choses, et comment le Bounded Replay règle le problème
- D'où viennent les « 8 Md activés en prefill contre 16 Md en decode »
4.1 Le point de départ : YoCo
Dans les workflows d'agents, les appels d'outils génèrent énormément de requêtes de prefill. Quand le cache KV n'est pas disponible (cache miss), il faut tout recalculer. CED s'inspire de YoCo (You Only Cache Once, Sun et al., 2024). Dans YoCo, la moitié haute des couches réutilise directement le cache KV produit par la moitié basse. CED reprend l'idée et ajoute des améliorations structurelles pour augmenter la capacité du cache KV et la profondeur de calcul qui le produit.
4.2 Attention globale : le décodeur se sert à la sortie de l'encodeur
Les L/2 = 20 couches du bas forment l'encodeur causal. Pour les couches du haut (le décodeur, l > L/2), les entrées KV globales ne sont pas calculées à partir de leur propre état caché Hl. Elles sont projetées directement depuis l'état caché de la dernière couche de l'encodeur, HL/2, avec des poids propres à chaque couche :
Imaginez une équipe de 40 personnes qui lit un dossier. Sans CED, chaque page passe entre les mains des 40. Avec CED, les 20 premières lisent chaque page et en rédigent une fiche. Les 20 suivantes ne consultent que ces fiches et ne s'impliquent vraiment que sur les toutes dernières pages, celles qui précèdent la réponse.
Combiné avec CSA2 (chapitre 5), c'est la couche du décodeur en mode Full qui calcule son KV global à partir de HL/2. Les autres couches du décodeur réutilisent ce KV.
4.3 Attention locale : le prix de la profondeur
Pour l'attention à fenêtre glissante, CED garde le calcul classique couche par couche : les clés et valeurs locales de la couche l viennent bien de son propre état caché Hl. Cela augmente la « profondeur de calcul » du KV local, mais crée une dépendance gênante.
Pour que le décodeur commence à générer, il lui faut le KV SWA des 128 derniers tokens dans chacune de ses couches. Or la fenêtre de la couche 30 dépend des sorties de la couche 29 sur une fenêtre plus large, qui dépendent elles-mêmes de la couche 28 sur une fenêtre encore plus large… Les fenêtres s'empilent. Reconstituer exactement ces états exige de faire passer environ nwin × L/2 = 128 × 20 = 2 560 tokens dans les couches du décodeur.
Pour des interactions multi-tours avec des messages courts, ce surcoût devient important : on rejouerait 2 560 tokens pour n'en lire que quelques centaines de nouveaux. Heureusement, des travaux antérieurs (Chen et al., 2025) ont montré que le champ récepteur effectif de SWA est bien plus petit que le champ théorique nwin × L/2. D'où le Decoder SWA Bounded Replay : le décodeur ne fait passer que les 128 derniers tokens du prompt pour construire son KV SWA. Les états obtenus sont approximatifs, et le papier constate un impact « négligeable » sur la qualité des réponses. Le mécanisme est détaillé au chapitre 8.
4.4 Le bilan : combien de calcul économise-t-on ?
4.5 D'où viennent 8 Md et 16 Md de paramètres activés ?
Pendant le prefill, presque tous les tokens du prompt ne traversent que les 20 couches de l'encodeur. Seuls les 128 derniers passent aussi dans le décodeur (bounded replay). Un token de prompt n'active donc qu'environ la moitié des paramètres : 8 Md. Un token généré pendant le decode, lui, traverse les 40 couches : 16 Md. Comme les charges d'agents sont dominées par la lecture, c'est le chiffre de 8 Md qui pèse le plus sur la facture.
CED fait calculer le KV global du décodeur à partir de la sortie de l'encodeur. La plupart des tokens du prompt ne traversent donc que la moitié du réseau. Le KV local (SWA), lui, reste calculé couche par couche. Pour éviter de rejouer 2 560 tokens, V4.1 accepte une reconstruction approximative sur 128 tokens seulement. Au total, le prefill coûte presque deux fois moins.
CSA2 : partager le cache entre les couches
Compressed Sparse Attention 2 est le cœur de la compression. Au lieu que chaque couche garde son propre cache global, quelques couches le produisent et les autres le réutilisent, parfois jusqu'à la sélection des entrées à lire.
5.1 Trois axes de compression qui se multiplient
Les auteurs décomposent le coût du cache KV selon trois dimensions multiplicatives :
- La taille de chaque entrée : GQA réduit le nombre de têtes KV ; MLA (DeepSeek-V2/V3) partage un petit vecteur latent entre toutes les têtes.
- La dimension séquence : on compresse m tokens consécutifs en une seule entrée, comme CSA et HCA dans V4.
- La dimension des couches : certaines couches réutilisent le cache ou les sélections d'autres couches au lieu de garder les leurs.
L'axe des couches avait déjà été exploré. IndexCache réutilise les indices top-k d'une couche à l'autre ; YOIO calcule le routage parcimonieux une seule fois pour tout le réseau ; HySparse fait réutiliser le KV de couches denses par des couches parcimonieuses. Mais chacune de ces méthodes a une limite, selon les auteurs. Réutiliser les indices n'économise pas le stockage du main KV. Partager le routage dans tout le réseau limite la performance. Les designs hybrides gardent des couches d'attention complète. Surtout, aucune ne couvre les trois axes à la fois. CSA2 les combine.
5.2 Anatomie d'une couche CSA2
Comme CSA, chaque couche CSA2 contient :
- le main KV : les entrées du cache global, chacune résumant m tokens consécutifs. m = 1, sans compression, est un cas particulier, utilisé dans le décodeur ;
- un indexeur léger : il note chaque entrée du main KV en combinant une indexer Q (calculée pour la requête) et une indexer K (une par entrée), puis garde les 512 meilleures ;
- l'attention principale : la requête (main Q) lit les entrées sélectionnées et le KV SWA local de la couche.
CSA2 simplifie aussi deux choses par rapport à CSA :
- Dans CSA, avec un ratio m, chaque entrée était fabriquée à partir de 2m entrées d'origine, avec chevauchement entre entrées voisines et un encodage de position absolue. CSA2 supprime le chevauchement et l'encodage absolu.
- CSA calculait l'indexer K par un chemin de compression séparé, depuis les états cachés. CSA2 obtient l'indexer K par une simple projection du main KV.
Les deux changements simplifient l'implémentation et accélèrent l'entraînement.
5.3 Les trois modes : Full, Reindex, Reuse
Chaque couche CSA2 reçoit, de façon statique (fixée dans l'architecture), l'un des trois modes. Dans les trois cas, la couche calcule sa propre requête (main Q) et son propre KV SWA, et produit une nouvelle sortie d'attention. Les modes diffèrent par la façon dont ils obtiennent trois choses : le main KV, l'indexer K et les indices top-k.
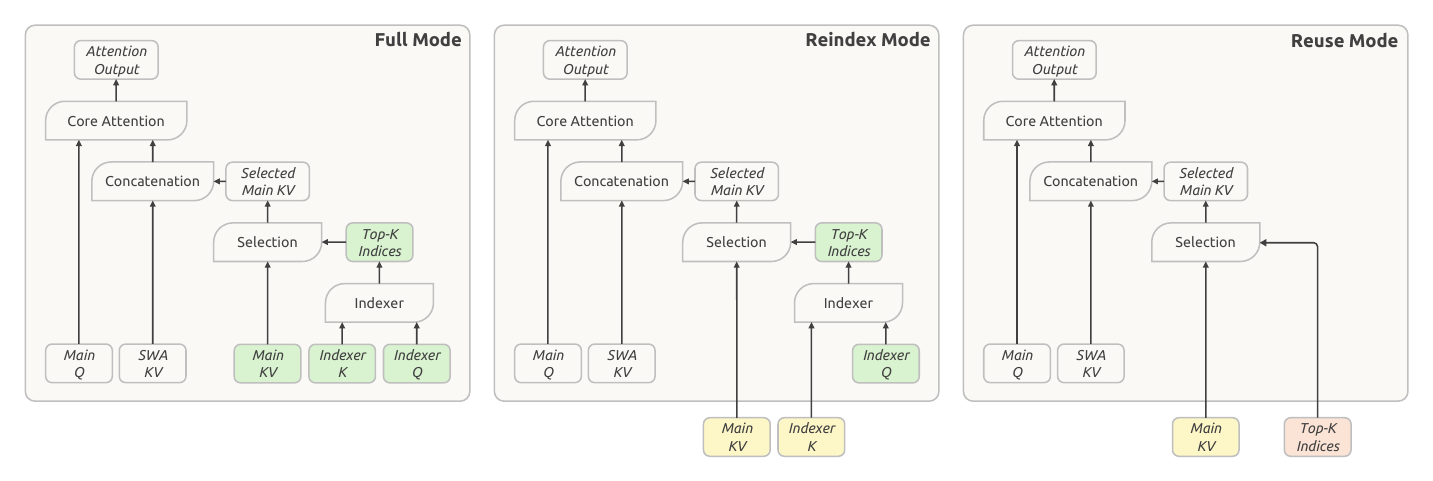
Deux mécanismes distincts sont à l'œuvre, et le papier insiste sur leur découplage :
- Partager le main KV et l'indexer K réduit le stockage du cache.
- Réutiliser les indices top-k évite du calcul d'indexeur.
Le mode Reindex est l'intermédiaire : le stockage est partagé, mais la couche choisit elle-même quelles entrées lire. La sélection peut ainsi évoluer d'une couche à l'autre.
5.4 Le plan de V4.1 : qui produit, qui réutilise
La répartition exacte des modes (section 4.2.1) :
- Encodeur : couches 0 et 1 en SWA pure, puis 18 couches CSA2 avec m = 2, en 3 groupes identiques de 6 couches : 1 Full + 5 Reuse.
- Décodeur : 20 couches CSA2 avec m = 1, en 5 groupes de 4. Premier groupe : 1 Full + 3 Reuse. Quatre groupes suivants : 1 Reindex + 3 Reuse. La couche Full du décodeur calcule son KV global depuis la sortie de l'encodeur (CED).
5.5 D'où viennent les 890 octets par token ?
Le papier annonce 890 octets de KV global par token, sans détailler le calcul. On peut pourtant le reconstituer exactement à partir des hyperparamètres publiés :
- Seules les couches Full stockent un KV global : 3 dans l'encodeur (avec m = 2, soit ½ entrée par token chacune) et 1 dans le décodeur (m = 1, 1 entrée par token). Total : 3 × ½ + 1 = 2,5 entrées par token.
- Une entrée de main KV a 512 canaux. En FP4, cela fait 512 × 4 bits = 256 octets, plus une échelle E4M3 d'1 octet par bloc de 16 canaux (32 octets). Total : 288 octets.
- Une indexer K de dimension 128 au format MXFP4 fait 64 octets, plus 4 échelles d'1 octet (une par bloc de 32). Total : 68 octets.
- 2,5 × (288 + 68) = 2,5 × 356 = 890 octets.
Ce calcul est le nôtre, pas celui du papier. Il suppose que l'indexer K est une seule tête de dimension 128 (la dimension de tête d'indexeur publiée) au format MXFP4 (adopté pour l'indexeur selon la section 2.4.4). Le fait qu'il retombe exactement sur 890 laisse penser que ces hypothèses sont les bonnes.
Dans V4.1, seules 4 couches sur 38 couches CSA2 stockent un KV global. Les autres le réutilisent (Reindex, Reuse). Le mode Reuse réutilise même la sélection des entrées. Cela ramène le cache à 2,5 entrées par token. Avec le FP4, on obtient 890 octets par token.
L'indexeur parcimonieux hiérarchique
Même avec la réutilisation, les couches Reindex notent encore tout le contexte visible. À un million de tokens, c'est un goulot. Solution : la première couche indexante restreint le terrain de recherche des suivantes.
Des travaux antérieurs (Xu et al., 2026) rendaient l'indexeur lui-même parcimonieux : ils notaient d'abord des représentations moyennées par blocs, puis ne regardaient en détail que les meilleurs blocs. Les auteurs remarquent que, dans le décodeur, l'information des indexeurs peu profonds peut naturellement restreindre les candidats des indexeurs plus profonds, sans aucun état supplémentaire.
Le mécanisme, utilisé uniquement dans le décodeur de CED :
- La couche Full du décodeur note toutes les positions.Elle parcourt tout le main KV visible et produit ses propres top-512 indices pour sa propre attention.
- Elle sélectionne des blocs.Chaque bloc de 8 positions reçoit le score maximal de ses positions. Les blocs les mieux notés (jusqu'à 2 048) sont retenus.
- Elle forme un pool de candidats.Les positions couvertes par ces blocs, jusqu'à 2 048 × 8 = 16 384, forment le terrain de recherche des couches suivantes. Ce pool est bien plus grand que le top-512 final.
- Les couches Reindex ne notent que le pool.Chacune garde son propre top-512 parmi les 16 384 candidats. Les couches Reuse, elles, n'indexent pas du tout.
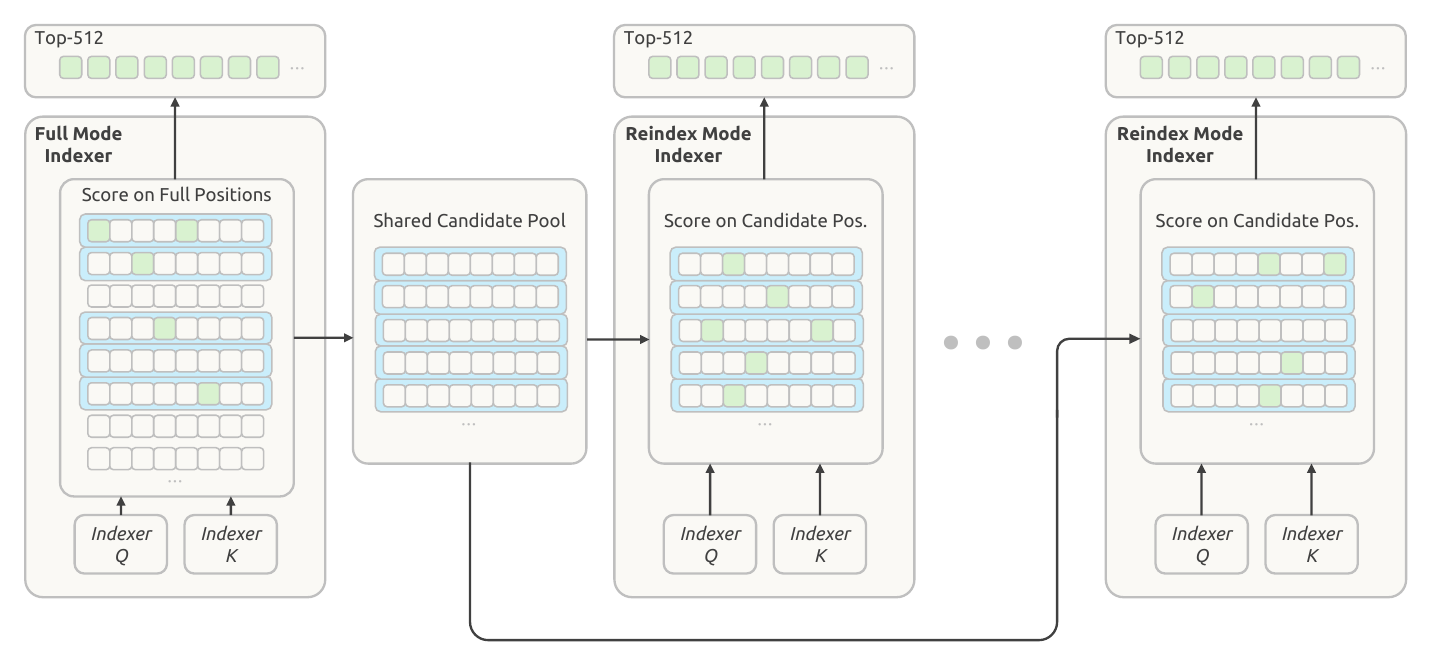
Pour une taille de pool fixe, le coût par requête des indexeurs profonds passe de linéaire en la longueur du contexte à constant. Seule la première couche Full continue de parcourir tout le contexte.
Le mécanisme est « conscient de l'entraînement » : il est introduit pendant le post-entraînement, et la restriction des candidats est appliquée à l'identique à l'entraînement et à l'inférence. Les indexeurs profonds sont donc optimisés pour le terrain de recherche qu'ils auront réellement en production.
La couche Full du décodeur fait un repérage global et désigne 16 384 positions candidates. Les couches Reindex ne cherchent que là : leur coût ne dépend plus de la longueur du contexte.
Le cache principal en FP4 : 4 bits par nombre
Deuxième levier : la précision. Chaque nombre du main KV est stocké sur 4 bits. Le secret pour ne pas perdre en qualité : un facteur d'échelle partagé par petits groupes de 16 valeurs, et un modèle entraîné pour s'y habituer.
7.1 D'où l'on part
DeepSeek-V4 utilisait déjà l'entraînement conscient de la quantification (QAT) pour stocker en FP4 les requêtes et clés de l'indexeur. Cela accélérait l'indexation et réduisait le cache de l'indexeur. Pour ces tenseurs, DeepSeek a choisi le format standard MXFP4 de l'OCP, compatible avec le plus de matériels possible, même si d'autres formats étaient plus précis dans leurs expériences.
V4.1 étend le QAT au main KV. Ici, le FP4 ne sert pas à accélérer des multiplications de matrices, seulement à réduire le stockage. Les valeurs sont décompressées avant l'attention. On peut donc choisir un format plus précis que MXFP4 sans exiger que le matériel sache multiplier nativement dans ce format.
7.2 Le format retenu : E2M1 + une échelle E4M3 tous les 16 canaux
Chaque valeur est un nombre flottant de 4 bits E2M1 : 1 bit de signe, 2 bits d'exposant, 1 bit de mantisse. Il ne peut représenter que 8 amplitudes :
Pour couvrir des valeurs plus grandes ou plus petites, chaque bloc de 16 canaux partage un facteur d'échelle stocké en E4M3 (un flottant 8 bits). C'est le schéma NVFP4, sans sa seconde échelle globale. Pourquoi peut-on s'en passer ? Les auteurs le justifient par un calcul de bornes :
- Le format peut représenter jusqu'à 448 (le max de E4M3) × 6 (le max de E2M1) = 2 688.
- Après normalisation RMS (poids de RMSNorm entraînés ≤ ~1), la norme L2 du vecteur latent de 512 canaux est au plus ≈ √512. La rotation RoPE préserve cette norme, donc aucune valeur ne dépasse ≈ 22,6.
- En pratique, le maximum observé pendant l'entraînement tourne autour de 10.
La marge est énorme. Supprimer l'échelle globale ne coûte donc « aucune perte mesurable de précision » et simplifie la disposition du cache.
7.3 Les choix de mise en œuvre
- QAT pendant le post-entraînement : le modèle apprend à fonctionner avec un cache FP4.
- Même format pour la partie avec RoPE et la partie sans RoPE du vecteur.
- Quantification après RoPE : quantifier avant n'apportait qu'un gain marginal de précision et aurait ajouté du travail à chaque pas de decode.
- Le KV SWA reste en FP8, car il est plus sensible à la quantification.
Par rapport au main KV en FP8 de V4, ce format divise presque par deux l'empreinte, en HBM comme sur SSD. Une entrée de 512 canaux passe de 512 octets à 288 octets.
4 bits par valeur + 1 octet d'échelle tous les 16 canaux = 4,5 bits par valeur en moyenne. Des bornes mathématiques simples garantissent qu'aucune échelle globale n'est nécessaire. Le cache principal devient presque deux fois plus léger qu'en FP8.
Le cache persistant et le SWA Bounded Replay
Troisième levier : le déploiement. Les auteurs constatent que stocker durablement le KV local (SWA) est à la fois coûteux et inutile. Ils le suppriment du cache persistant, et rendent ses absences bon marché.
8.1 Comment V4 gérait le cache persistant
Dans le déploiement de V4, un cache persistant sur SSD, avec une politique d'éviction LRU (on jette ce qui a servi le moins récemment), gère séparément deux types de KV :
- le KV global, stocké en entier : un hit permet de réutiliser tout le préfixe ;
- le KV SWA, stocké à deux endroits précis : la fin du prompt et la fin de la réponse. Cela permet de régénérer une réponse ou de continuer une conversation à partir de ce point.
Le cache était dimensionné pour que les deux types restent résidents plus de 72 heures en charge typique. Problème : bien qu'on ne garde que nwin entrées SWA à ces positions, ce KV SWA non compressé occupait près de la moitié de la capacité du cache persistant, surtout dans les conversations à tours courts.
8.2 Le constat : deux KV, deux durées de vie
Réutilisation « longue traîne »
Un long préfixe (un dépôt de code, une documentation) peut être relu des heures ou des jours plus tard. Le garder longtemps sur SSD est rentable.
Utile quelques minutes
Il ne sert qu'à l'intérieur d'une session active. Il devient inutile dès que la session se termine ou que le tour suivant commence. Le garder 72 h est du gaspillage.
Le rapport de V4 proposait déjà un « Zero SWA Caching » : ne pas stocker le KV SWA et le recalculer s'il manque. Mais la reconstruction exacte exige une passe complète sur L × nwin tokens, un coût jugé prohibitif en production.
8.3 La nouvelle gestion dans V4.1
- Le KV SWA quitte le cache persistant.Il est placé dans un pool de mémoire distribué, constitué de 10 % de la DRAM de chaque machine. Ce pool est bien plus petit, mais sa durée de vie très courte (quelques minutes) permet de recycler immédiatement les entrées expirées. En charge réelle, cela suffit à servir la grande majorité des sessions actives. Le KV global reste dans le cache persistant, avec une durée de vie garantie d'au moins 72 h.
- Les absences deviennent bon marché : Encoder SWA Bounded Replay.Pour les requêtes, rares mais inévitables, qui trouvent le KV global mais pas le KV SWA, on ne recalcule que nwin = 128 tokens au lieu d'une passe complète sur L × nwin tokens. Selon le papier, ce rejeu borné est la « pierre angulaire » du design : il transforme un miss catastrophique en une dégradation douce et peu coûteuse.
8.4 Comment marche le rejeu borné
Les dépendances SWA s'accumulent de couche en couche (revoir le cône du chapitre 4). Le rejeu borné accepte donc des états approximatifs : il ne rejoue que les nwin derniers tokens et tronque l'attention SWA au segment rejoué. Pour un rejeu commençant à la position s, une requête en position i ne regarde que les clés SWA dans l'intervalle :
Encoder SWA Bounded Replay
Quand le KV SWA de l'encodeur manque, on rejoue les 128 derniers tokens du préfixe en cache, avec la partie non cachée. Les tokens rejoués ne régénèrent que du KV SWA : le KV global en cache est réutilisé tel quel, sans recalcul ni écrasement. La partie non cachée génère les deux.
Effet : le cache de préfixe ne dépend plus que du KV global, et le KV SWA peut disparaître du cache persistant.
Decoder SWA Bounded Replay
À chaque prefill, on fait passer les sorties d'encodeur des 128 derniers tokens du prompt dans les couches du décodeur, avec la même troncature. Le KV SWA du décodeur ainsi obtenu sert au decode, jamais au cache de préfixe.
Effet : la passe avant du décodeur est bornée à 128 tokens, ce qui divise presque par deux le prefill total.
Les états rejoués ne sont pas mathématiquement identiques à ceux d'une passe complète. Côté encodeur, le KV calculé pour la partie non cachée dépend même de la position où le cache a été trouvé. Les auteurs rapportent que la stratégie « compromet à peine » la qualité des réponses. Par sécurité, le rejeu du décodeur est aussi simulé pendant le post-entraînement, pour que le modèle s'y adapte.
8.5 Le compte final : ⅛
La réduction du cache persistant par 8 résulte de deux facteurs qui se multiplient :
Le KV global (utile longtemps) reste sur SSD au moins 72 h. Le KV SWA (utile quelques minutes) vit dans un petit pool en RAM. S'il a expiré, on le reconstruit approximativement en rejouant 128 tokens. Cache persistant : ½ (plus de SWA) × ¼ (KV global) = ⅛ de V4-Flash.
Single-Pass mHC : un seul passage en mémoire
Une extension plus discrète, mais typique de l'ingénierie DeepSeek : décaler un coefficient d'un bloc supprime une dépendance et permet de fusionner trois noyaux GPU en un. Le trafic mémoire des activations est divisé par deux.
9.1 Rappel : les hyper-connexions mHC
Dans un Transformer classique, un seul « flux résiduel » traverse les couches : chaque bloc lit ce flux, calcule, et ajoute son résultat. mHC (manifold-constrained Hyper-Connections, Xie et al., 2026), introduit dans V4, maintient n flux résiduels en parallèle (n = 4 dans V4.1). Pour chaque token, ces flux forment une matrice Xl ∈ ℝn×d, mise à jour ainsi :
9.2 Le problème : trois passages en mémoire au lieu d'un
Idéalement, la transition entre deux blocs serait une seule opération : lire (n + 1)d valeurs (les flux + la sortie du bloc précédent) et en écrire (n + 1)d. Cela donne une borne inférieure de (2n + 2)d de trafic mémoire. V4 utilisait en pratique trois noyaux successifs, à cause des dépendances de données :
9.3 L'astuce : utiliser les coefficients du bloc précédent
Single-Pass mHC décale les coefficients de mélange d'entrée d'un bloc. Chaque bloc utilise les coefficients A produits par le bloc précédent :
En pré-entraînement, DeepSeek garde l'implémentation multi-noyaux : le décalage ne change que les coefficients appliqués par chaque bloc. En déploiement, un noyau fusionné unique, Mega-mHC, fait la mise à jour du résiduel, le mélange d'entrée, la prédiction des coefficients, la pré-normalisation et la conversion FP8. Le résiduel est lu une fois et écrit une fois : on atteint la borne idéale et on divise par deux le trafic mémoire des activations par rapport à l'implémentation d'origine.
En utilisant Al−1 au lieu de Al, le mélange d'entrée n'attend plus la fin d'un calcul global. Tout tient en un seul passage : (2n + 2)d au lieu de (4n + 4)d.
Engram : une mémoire que l'on consulte par hachage
196 milliards de paramètres qui ne coûtent presque aucun calcul. Engram sépare la mémorisation (retenir des associations fréquentes de tokens) du calcul (raisonner).
Engram (Cheng et al., 2026) est un module de mémoire conditionnelle déjà publié par DeepSeek. L'idée : beaucoup de connaissances sont liées à des suites de tokens précises (« Tour Eiffel », « import numpy as »…). Au lieu de les faire « recalculer » par les couches, on les range dans d'énormes tables d'embeddings, adressées par un hachage des N-grammes qui précèdent le token courant. Pour chaque token, on lit quelques lignes de table : c'est un accès mémoire, pas un calcul lourd.
V4.1 reprend la conception d'origine : compression du vocabulaire (tokenizer compression), hachage multi-têtes, porte (gating) dépendant du contexte, intégration multi-branches. Il y apporte deux modifications :
- la courte convolution causale est retirée : ses gains ne justifiaient pas la complexité ajoutée dans le moteur d'inférence ;
- les tables sont optimisées par une mise à jour à momentum suivie d'un équilibrage de Sinkhorn (chapitre 13).
paramètres, répartis également entre 2 modules placés aux couches 1 et 14 (indexées à partir de 0), pour équilibrer la mémoire entre les étages du pipeline d'entraînement.
ordres de N-grammes, 8 têtes de hachage, dimension totale d'embedding de 2 048 par ordre. Chaque tête indexe une table d'environ 16 M entrées, avec des tailles de table qui sont des nombres premiers distincts.
pour les tables d'embeddings et les projections clé/valeur. Les valeurs lues et leurs facteurs d'échelle sont passés directement au produit matriciel suivant.
3 ordres × 8 têtes × ~16 M entrées × 256 dimensions par tête (2 048 / 8) ≈ 98 Md de paramètres par module, soit ≈ 196 Md pour deux modules. Ce calcul est le nôtre, mais il colle au chiffre du papier.
Le bénéfice système : on peut précharger
Point crucial pour l'inférence : l'adressage est déterministe. Les lignes à lire ne dépendent que des tokens d'entrée, pas des calculs du réseau. On peut donc les précharger depuis la mémoire de l'hôte par des transferts RDMA en arrière-plan, avant même d'en avoir besoin. Pour le premier module (couche 1), ce préchargement se fait pendant le calcul du premier bloc Transformer. Ainsi, ces 196 Md de paramètres n'occupent pas la précieuse HBM.
À l'entraînement, le même principe permet de lancer le préchargement pour tout le lot local avant que chaque étage du pipeline ne commence. Les tables sont partitionnées par lignes entre des groupes de processus dédiés. Pendant les rollouts de RL, en revanche, elles restent en mémoire GPU pour soulager la mémoire de l'hôte.
Engram ajoute beaucoup de capacité de mémorisation pour un coût de calcul minime. Comme les adresses se déduisent des tokens d'entrée, les tables peuvent vivre hors du GPU et être préchargées à temps.
DSpark : deviner plusieurs tokens, vérifier d'un coup
Le decode est limité par la mémoire : générer un token ou en vérifier cinq coûte presque pareil. DSpark exploite ce fait avec un « brouillon » rapide et un ordonnanceur qui décide combien de tokens vérifier selon la charge.
11.1 Le principe du décodage spéculatif
Un petit modèle rapide (le drafter) propose plusieurs tokens d'avance. Le grand modèle les vérifie tous en une seule passe, comme un mini-prefill. On garde le plus long préfixe accepté, plus un token que le grand modèle produit lui-même au passage. Si le brouillon est bon, on avance de plusieurs tokens pour le prix d'un pas de decode.
11.2 Ce que fait DSpark
- Le drafter : 3 blocs Transformer avec une fenêtre d'attention glissante de 128 tokens.
- Brouillon semi-autorégressif : une seule passe dans ces blocs calcule les logits de base pour 5 positions de brouillon en parallèle. Une tête de Markov légère modélise ensuite les dépendances entre ces tokens.
- Une tête de confiance prédit, pour chaque position, la probabilité conditionnelle d'acceptation. On en déduit la probabilité de « survie » de chaque préfixe.
- L'ordonnanceur combine ces estimations avec des courbes de débit mesurées sur le moteur. Il choisit dynamiquement, pour chaque requête, combien de tokens vérifier, afin de maximiser le débit total attendu sous la charge actuelle.
11.3 Un entraînement à part
Contrairement au module MTP de DeepSeek-V3, entraîné avec le backbone pendant tout le pré-entraînement, DSpark arrive dans une étape dédiée après le pré-entraînement. Seul DSpark est entraîné, le backbone reste gelé. Pendant le post-entraînement, DSpark continue d'être entraîné avec le backbone, mais sans propager de gradient de son objectif vers le backbone. Il reste ainsi aligné sur la politique qui évolue. Il accélère alors à la fois le service en ligne et la génération des rollouts pour le RL et la distillation (OPD).
DSpark devine 5 tokens en une passe, estime la chance que chaque préfixe soit accepté, et laisse un ordonnanceur choisir la longueur de vérification selon la charge du serveur.
Un modèle nativement multimodal
V4.1-Flash lit des images dès le premier jour du pré-entraînement. Son encodeur visuel est entraîné maison, et une astuce de réarrangement divise par neuf le nombre de tokens par image.
12.1 Le chemin d'une image
- L'encodeur visuel découpe l'image en patchs.DeepSeek-ViT produit une grille spatiale de vecteurs, un par patch de 14 × 14 pixels.
- Pixel-unshuffle 3 × 3.Chaque voisinage de 3 × 3 patchs est réarrangé le long de la dimension des canaux : 9 vecteurs deviennent 1 vecteur 9 fois plus large. La résolution spatiale est divisée par 3 dans chaque direction, et le nombre de tokens visuels par 9.
- Le projecteur MLP (2 couches) projette ces vecteurs dans la dimension cachée du modèle de langage (5 120).
- Insertion dans la séquence.Les embeddings visuels prennent la place des tokens-image dans la séquence d'entrée et sont traités conjointement avec le texte par le backbone.
12.2 DeepSeek-ViT, entraîné de zéro
L'encodeur visuel suit l'architecture Vision Transformer avec plusieurs modifications, toutes pensées pour ressembler davantage à un LLM :
- 2D-RoPE à la place des embeddings de position absolus, pour accepter des résolutions arbitraires ;
- la convolution d'embedding des patchs est remplacée par une projection linéaire, compatible avec l'optimiseur Muon ;
- RMSNorm et SwiGLU, comme dans le backbone ;
- 32 couches, dimension 1 024, 16 têtes. Les résolutions sont supportées jusqu'à environ 1 344 × 1 344 pixels.
Son entraînement se fait en deux étapes, avant l'intégration au backbone :
SigLIP sur ~47 Md de paires
Perte contrastive sigmoïde (SigLIP) sur environ 47 milliards de paires image-texte issues de textes alternatifs, à au plus 224 × 224 px. Monter en résolution à ce stade aidait, mais n'apportait presque rien au modèle final pour un surcoût de calcul important.
236 Md de tokens avec un petit LLM
L'encodeur est branché à un LLM MoE de 4 Md et entraîné en prédiction du token suivant sur des légendes, textes alternatifs, graphiques et OCR. La résolution est bornée entre 544 × 544 et 1 344 × 1 344. Ensuite, on jette le petit LLM et on garde l'encodeur.
Pendant le pré-entraînement du modèle complet, l'encodeur visuel reste gelé jusqu'à la phase de décroissance du taux d'apprentissage. Seuls sa normalisation finale et le projecteur restent entraînables. Il est ensuite dégelé et optimisé avec le LLM, avec un taux d'apprentissage plus faible.
12.3 Équilibrer les experts… par modalité
DeepSeek équilibre la charge des experts MoE sans perte auxiliaire. Chaque expert a un biais de correction ajouté au score de routage : on le baisse si l'expert est surchargé, on le monte s'il est sous-utilisé. Problème : les tokens d'image et de texte n'ont pas les mêmes préférences. Équilibrer la charge totale peut cacher un fort déséquilibre au sein de chaque modalité.
V4.1 maintient donc deux jeux de biais, un pour le texte et un pour les images. Chaque token choisit ses experts avec les biais de sa modalité, mais pondère leurs sorties avec les scores d'origine. Après chaque pas, les deux jeux sont mis à jour indépendamment, avec une vitesse de 0,001.
Les images passent par un ViT maison (2D-RoPE, projection linéaire, RMSNorm, SwiGLU), puis sont compressées ×9 par pixel-unshuffle avant d'entrer dans le même flux que le texte. Le routage MoE est équilibré séparément pour chaque modalité.
Optimiseurs : Muon par tête et mises à jour équilibrées par Sinkhorn
Deux ajustements à la recette d'optimisation de V4, alignés sur les nouveautés d'architecture. L'un gère la diversité des têtes d'attention, l'autre dompte les énormes tables d'Engram sans exploser la mémoire.
13.1 Qui optimise quoi
| Paramètres | Optimiseur |
|---|---|
| Matrices des transformations linéaires (backbone, projections d'Engram, projecteur vision-langage) | Muon (momentum 0,95, weight decay 0,1, RMS de mise à jour ramené à 0,18, Nesterov) |
| Poids des requêtes et des clés | Muon par tête (head-wise) |
| Tables d'Engram, embedding des tokens, tête de prédiction | Momentum + équilibrage de Sinkhorn (K = 11, τ = 10−3, ε = 10−20, sans weight decay) |
| Normalisations, biais, facteurs d'échelle | AdamW (β1 = 0,9, β2 = 0,95, ε = 10−20, weight decay 0,1 sauf biais et échelles) |
13.2 Muon par tête
Muon peut être vu comme une descente de gradient préconditionnée : il « orthogonalise » la mise à jour d'une matrice de poids avant de l'appliquer (itérations de Newton-Schulz). Le Muon standard utilise un préconditionneur pour toute la matrice des requêtes, donc pour toutes les têtes à la fois. Le Muon par tête découpe d'abord cette matrice tête par tête. Chaque tête reçoit ainsi son propre préconditionneur, ce qui gère mieux l'hétérogénéité entre têtes d'attention. DeepSeek observe qu'il surpasse le Muon standard ; GLM 5 et Kimi-K3 ont fait le même constat.
13.3 Mises à jour équilibrées par Sinkhorn
Appliquer Adam aux 196 Md de paramètres d'Engram aurait fait exploser la mémoire. Adam garde deux états par paramètre (moyenne et variance des gradients). DeepSeek utilise à la place une mise à jour à momentum (un seul état, comme Muon) suivie d'un équilibrage de Sinkhorn. Elle surpasse Adam empiriquement.
La procédure suit le même schéma que Muon, en remplaçant l'orthogonalisation par une normalisation alternée des lignes et des colonnes de la mise à jour :
- une ligne correspond à un token ou à un N-gramme (l'identité à mémoriser), une colonne à une dimension cachée ;
- on divise alternativement chaque ligne, puis chaque colonne, par sa norme. Avec un nombre impair d'étapes (K = 11), on finit par une normalisation des lignes ;
- on multiplie par √n pour passer d'une norme L2 unitaire à un RMS unitaire par ligne ;
- les lignes quasi nulles (norme ≤ τ × moyenne) sont masquées pour la stabilité numérique ;
- le taux d'apprentissage est corrigé par γ = 0,18 pour égaler l'amplitude des mises à jour d'Adam (proche du 0,2 utilisé dans Moonlight).
Résultat : les RMS par ligne et par colonne de la mise à jour sont approximativement égalisés à 1.
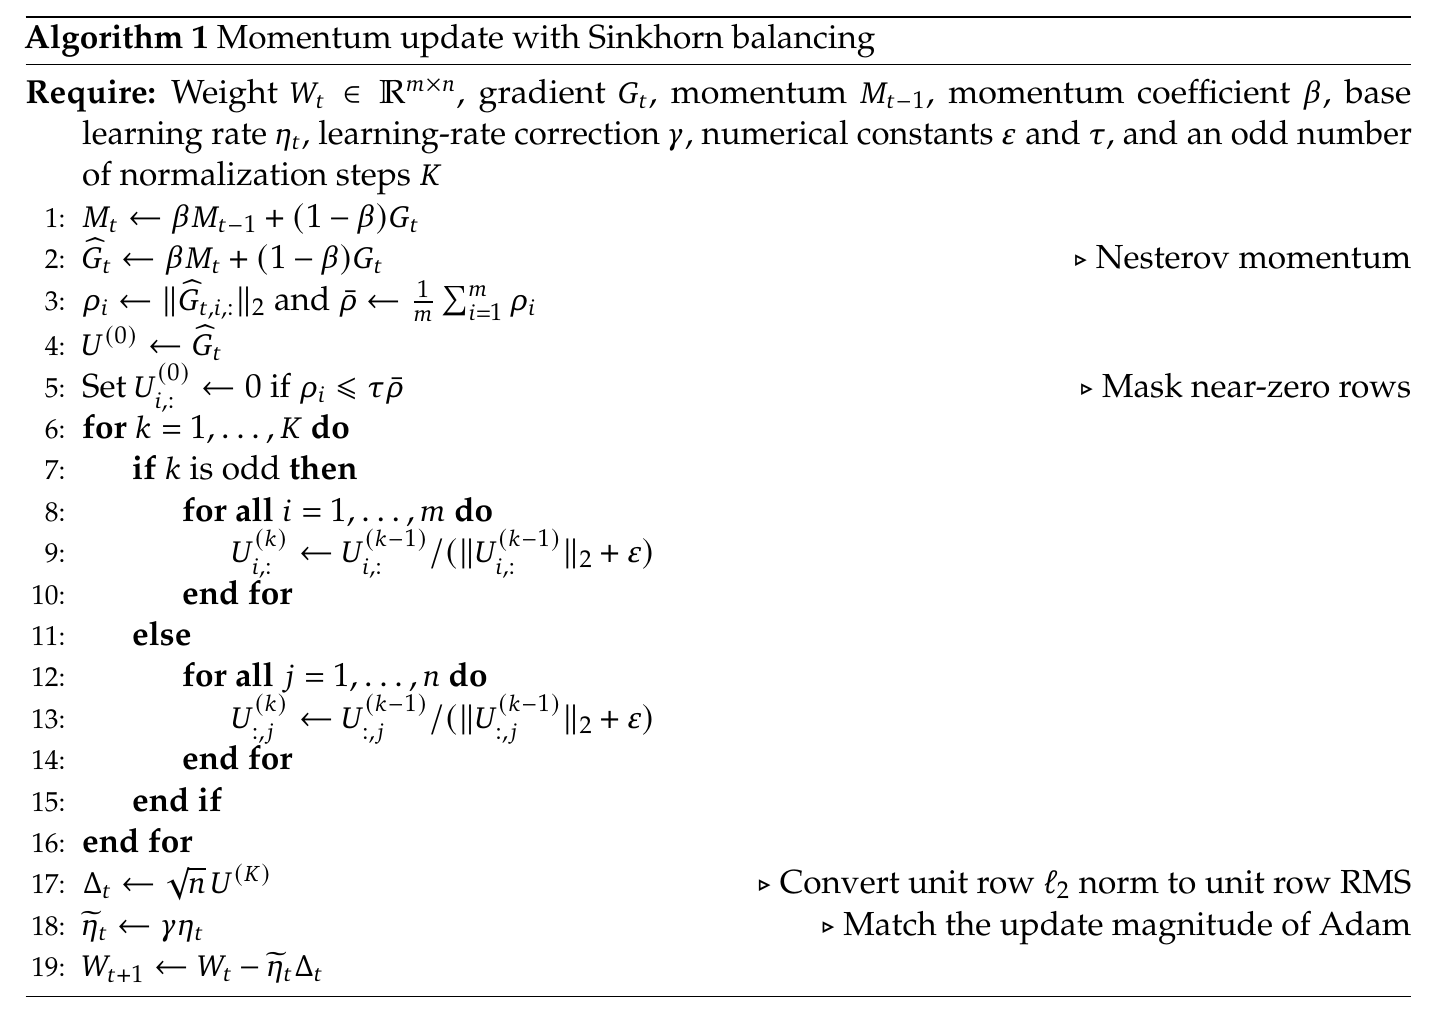
Muon par tête donne à chaque tête d'attention son propre préconditionneur. L'équilibrage de Sinkhorn offre aux grandes tables d'embeddings une mise à jour bien normalisée, avec un seul tampon de momentum au lieu des deux états d'Adam.
L'infrastructure : faire tourner tout ça efficacement
Une architecture qui partage des états entre couches, des images de toutes tailles, des tables de 196 Md de paramètres… Chaque idée a demandé un travail d'infrastructure dédié, côté entraînement comme côté inférence.
14.1 Entraînement multimodal
Recouvrir la communication pendant l'apprentissage contrastif
Dans la phase contrastive de l'encodeur visuel, la perte est calculée sur tout le lot. Il faut donc rassembler (all-gather) les vecteurs texte et image de toutes les machines, ce qui représente beaucoup de communication. Mais le gradient des vecteurs texte ne dépend que des vecteurs image rassemblés, et inversement. Chaque rassemblement peut donc se faire pendant un calcul utile :
Encodeur visuel « désagrégé »
L'encodeur visuel est répliqué en dehors de l'arbre de paramètres du LLM. Chaque pas d'entraînement a trois phases : forward vision, forward/backward LLM, backward vision. La phase LLM reste exempte de calcul visuel et garde la stratégie de parallélisme du texte seul.
Images réparties, lues une fois
Une séquence ultra-longue riche en images peut saturer une machine au chargement. Ses images sont donc réparties, avec équilibrage de charge, entre les rangs de parallélisme de contexte, et chacune n'est chargée qu'une fois.
Transfert incrémental en RL
Pendant les rollouts de RL, les images ne sont envoyées au moteur d'inférence qu'incrémentalement. Les résultats de décodage et de prétraitement sont mis en cache sur un système de fichiers distribué, réutilisés d'un rollout à l'autre et pour l'entraînement.
Entraîner une attention qui partage des états entre couches
Avec CSA2, une couche peut réutiliser le main KV, l'indexer K ou les indices d'une autre couche. Or ces couches peuvent se trouver sur des étages différents du pipeline, donc sur des GPU différents. Trois mécanismes rendent cela transparent :
- Indexeurs fantômes (shadow indexers) : une réplique légère et exécutable sur chaque étage concerné, avec un seul propriétaire logique des paramètres partagés. Le propriétaire gère l'optimisation et les checkpoints. La synchronisation des paramètres et l'agrégation des gradients gardent les répliques cohérentes.
- Extensions de la charge utile du pipeline : les représentations intermédiaires et les informations de routage parcimonieux voyagent avec les communications point à point existantes quand la source et le consommateur sont de part et d'autre d'une frontière d'étage.
- Gestion des états partagés par micro-lot : on suit la durée de vie de chaque état partagé à travers forward, recalcul des activations et backward. Chacun est libéré dès que son dernier consommateur a fini.
14.2 Inférence
noyaux GPU seulement pour une couche en mode Reuse, en prefill / en decode. C'est la grande majorité des couches. Les noyaux fusionnés viennent de FlashMLA (RoPE-attention-RoPE-cast), DeepGEMM (Mega-Gate, Mega-mHC, Mega-MoE), TileKernels et DeepSelect (top-k).
Encodage visuel, prefill et decode tournent sur des ressources séparées. Ils passent à l'échelle indépendamment et s'exécutent en recouvrement.
Le KV global, à longue durée de vie, est séparé du KV SWA de l'encodeur, à courte durée de vie. Le rejeu borné reconstruit ce dernier s'il manque (chapitre 8).
Recouvrement communication-calcul, tables Engram réparties (sharded), chemins de Bounded Replay distincts pour l'encodeur et le décodeur.
« Bien que l'architecture soit conceptuellement complexe, le flux de noyaux d'inférence qui en résulte est remarquablement concis. »
Pré-entraînement : 45 000 milliards de tokens
Des données plus exigeantes, un mélange texte-image dès le départ, et un entraînement de l'attention parcimonieuse « from scratch ». Le résultat : un modèle de base qui rivalise avec V4-Pro, trois fois plus gros.
15.1 Les données
Chercher le gain d'information
Au-delà de la qualité échantillon par échantillon, l'équipe s'intéresse aux interactions entre corpus qui apportent une information unique. Une « échelle » d'expériences sur les paramètres et les données guide les grands entraînements.
Le contenu généré par des modèles à faible gain d'information est filtré : sorties de modèles moins capables, traductions automatiques de mauvaise qualité. Les auteurs le considèrent comme de la duplication implicite, nuisible sur de longs entraînements. Le corpus inclut aussi plus de code récent (nouveaux dépôts, commits, bibliothèques, frameworks).
Le web tel quel, bien nettoyé
Trois familles : paires image-texte (texte alternatif, seuil de pertinence, déduplication sémantique), données entrelacées image-texte (pages web et PDF) et données de domaine (localisation visuelle, pointage, OCR, connaissances rares, paires image-code, trajectoires d'utilisation d'ordinateur).
Pas de synthèse massive : la priorité est de nettoyer et d'utiliser les données brutes. Le crawler, trop centré texte, a été relancé à partir de Common Crawl. Les données entrelacées passent par des étapes de filtrage de plus en plus coûteuses, jusqu'à une notation stricte par SmolVLM.
Les deux pipelines sont fusionnés : quand un échantillon existe en version texte et multimodale, la version multimodale remplace l'autre. Le corpus final a un ratio de 7:1 entre tokens texte seul et tokens multimodaux. L'algorithme de remplissage des séquences (best-fit packing) atteint un taux de padding d'au plus 10−4.
15.2 Le déroulé de l'entraînement
Le lot est fixé à 100,6 millions de tokens pendant tout l'entraînement. L'attention parcimonieuse est entraînée dès le départ à une longueur de séquence de 64K, sans phase d'échauffement en attention dense. La séquence passe à 1M à 34T tokens. Le papier précise : « sans aucune instabilité ».
15.3 Le modèle de base face à ses aînés
Le tableau 1 compare trois modèles de base évalués dans le même cadre interne : V4-Flash-Base (284 Md, 13 Md activés), V4-Pro-Base (1,6 T, 49 Md activés) et V4.1-Flash-Base (552 Md, 8 / 16 Md activés). Les écarts de 0,3 point ou moins sont considérés comme équivalents.
Pour mesurer les capacités en conditions réelles de R&D, l'équipe mesure aussi la perplexité sur des corpus internes jamais vus : documentation interne, dépôts de code propriétaires, documents académiques. La métrique est le nombre de bits par octet (BPB, bits-per-byte) : plus il est bas, mieux le modèle « comprime », donc prédit, le texte.
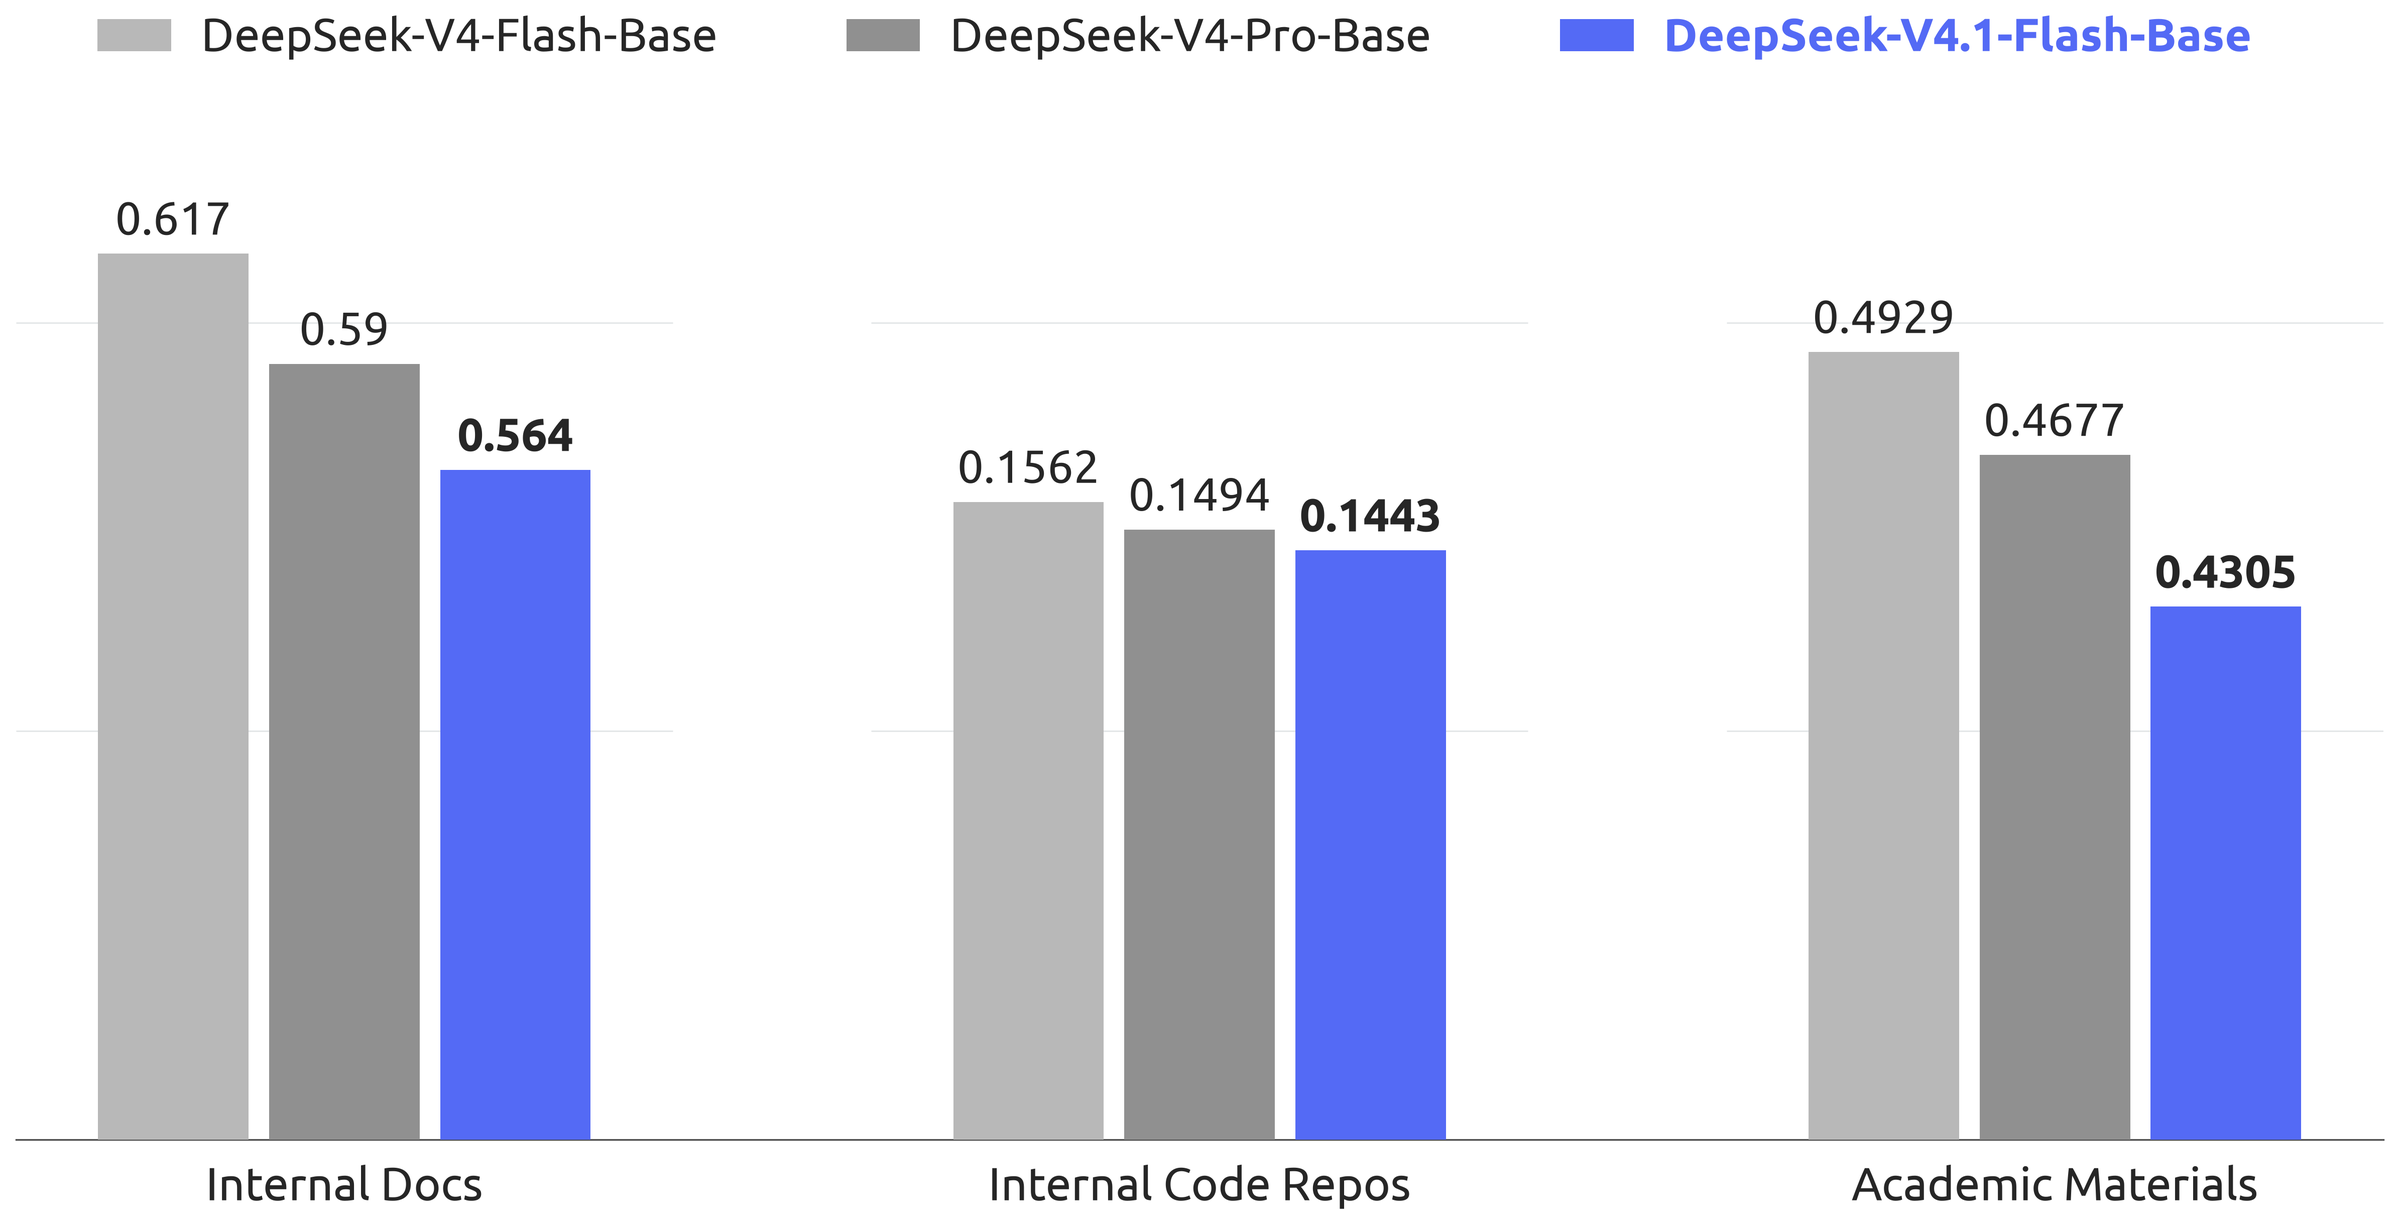
V4.1-Flash-Base atteint le niveau de connaissance et de raisonnement de V4-Pro-Base avec environ ⅓ de ses paramètres totaux et ¼ de ses paramètres activés. Sur les évaluations internes jamais vues, le papier annonce des gains de 5 à 10 %. Les auteurs y voient la marque d'une meilleure curation des données.
Post-entraînement : tout est dans les données
Aveu rare dans un rapport technique : aucune innovation algorithmique en post-entraînement. Les gains viennent presque entièrement de pipelines automatisés qui fabriquent des tâches, des environnements et des vérifications à très grande échelle.
La recette est standard : SFT (fine-tuning supervisé), puis RL (apprentissage par renforcement), puis OPD (distillation on-policy), sans modification par rapport à V4. L'effort porte sur trois étapes :
- synthétiser des tâches variées et vérifiables, avec leurs solutions de référence et leurs signaux de récompense ;
- construire procéduralement des environnements d'agents interactifs où collecter et évaluer des trajectoires à bas coût ;
- filtrer, dédupliquer et calibrer la difficulté.
Au stade actuel, le rendement marginal de l'ingénierie des données et des environnements dépasse « substantiellement » celui de la nouveauté algorithmique en post-entraînement.
16.1 Fabriquer des tâches à grande échelle
Chaque tâche est un triplet : (problème, environnement, système de vérification). Sa qualité se juge sur deux axes : la difficulté (non triviale) et la correction (aucun défaut critique dans les trois composantes). Le modèle commence à savoir construire ses propres tâches d'entraînement. DeepSeek l'entraîne donc à en construire de meilleures, avec la difficulté et la correction comme récompenses. Chaque tâche est surveillée toute sa vie : chaque nouvelle utilisation en RL fournit des trajectoires qui permettent de la réauditer.
Rejouer le monde réel
Des employés et partenaires utilisent le dernier modèle dans leur travail quotidien et, volontairement, renvoient données et retours. À partir des interfaces observées, on construit de nombreux outils simulés qui reproduisent les formats, schémas d'API et comportements d'outils réels : SaaS, logiciels d'entreprise, back-ends métiers. Les échecs remontés servent à générer des environnements qui rejouent les erreurs du modèle pour les corriger par RL.
Une chaîne d'agents spécialisés
Deux sources : des sessions d'agents de code (tâches complexes ou mal réussies, dédupliquées par trajectoire) et des dépôts GitHub publics au-delà d'un seuil d'étoiles. La construction de chaque environnement est confiée à plusieurs agents :
- Agent de conceptionVérifie que le projet se construit, tourne dans un conteneur et peut être vérifié automatiquement. Il choisit un point de départ (un tour, un commit), conçoit plusieurs directions d'implémentation assez complexes et produit des points d'évaluation (fail-to-pass et pass-to-pass).
- Agent d'installationInstalle les dépendances, le répertoire de travail, les tests et la description de tâche dans un conteneur isolé. Il s'auto-teste, efface toute trace pouvant révéler la solution et empaquette l'environnement en nouvelle couche d'image.
- Agents solveursPlusieurs agents distincts tentent la tâche.
- Agent d'inspection qualitéExamine l'environnement et les trajectoires : problèmes d'environnement, erreurs factuelles, incohérences entre évaluation et description, risques de triche (hackability).
- Agent de réparationSi l'inspection échoue, il corrige les erreurs, ajuste les points d'évaluation trop faciles ou trop durs, et la tâche repart en vérification.
16.2 Passer le RL à l'échelle
Le RL asynchrone à grande échelle est poussé dans deux directions : le calcul d'entraînement et le nombre de scaffolds (les « harnais » d'agents : Claude Code, OpenCode, Pi, DeepSeek Harness…). La performance continue de monter avec les pas de RL, que ce soit dans un seul scaffold, entre versions d'un même scaffold ou entre scaffolds hétérogènes.
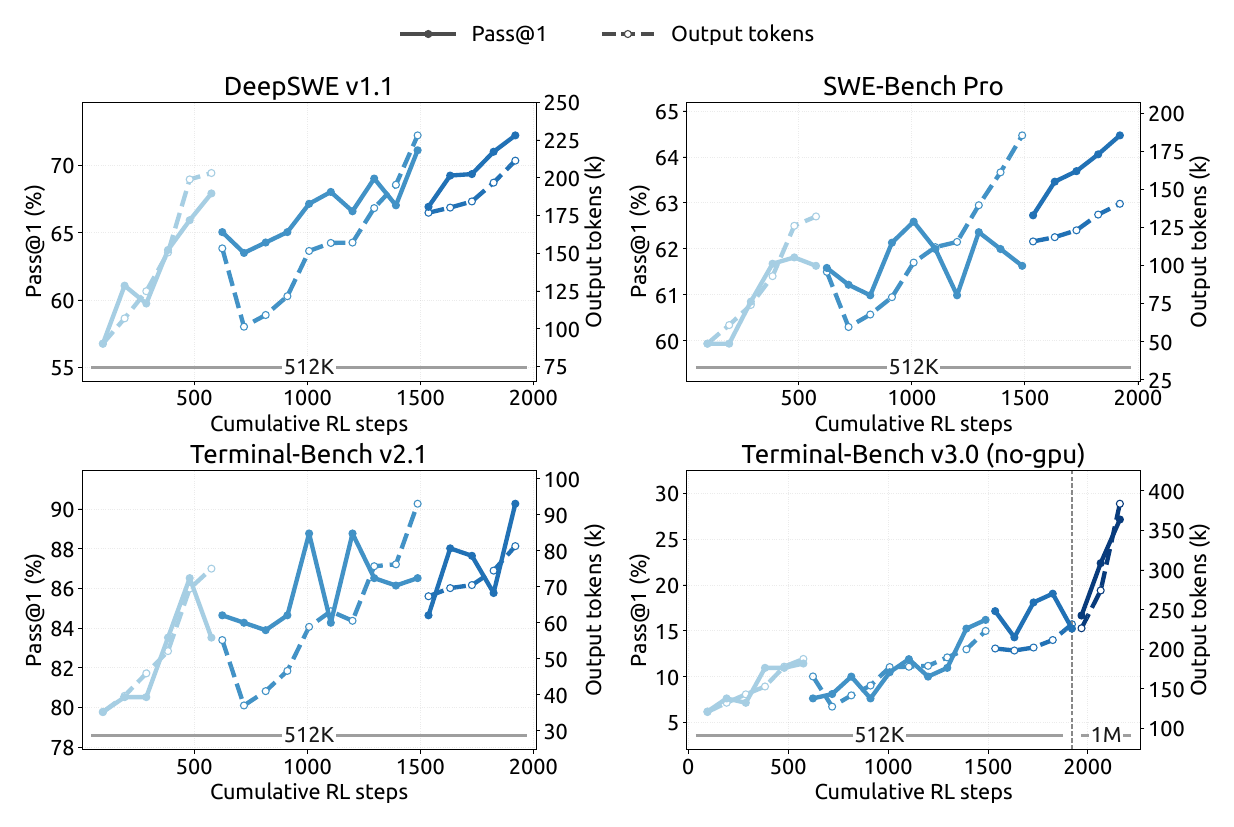
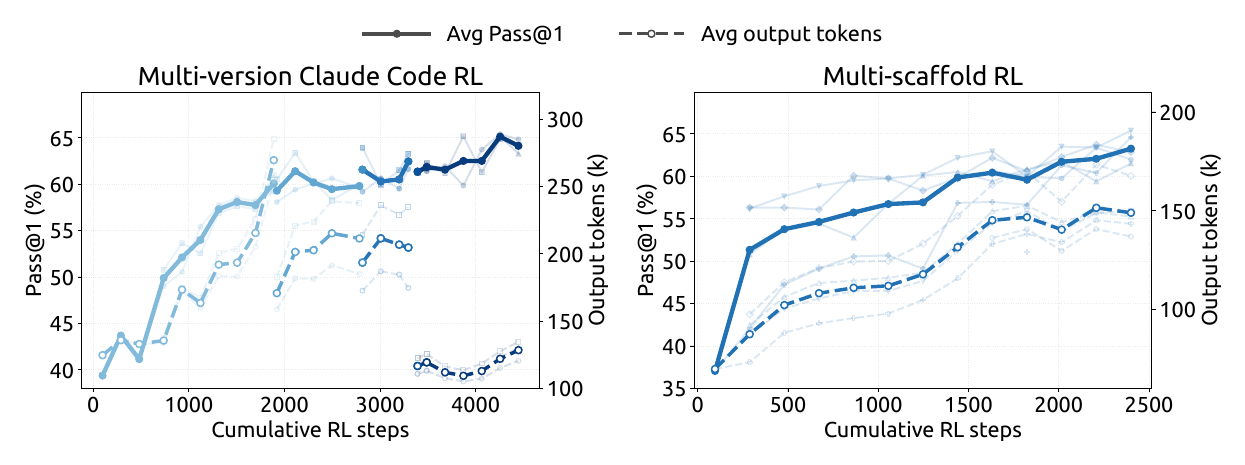
Deux idées d'ingénierie accompagnent ce passage à l'échelle :
- Séparer le scaffold du contrôle : un sandbox d'agent fait tourner le scaffold et ses outils. Un conteneur worker orchestre le rollout de façon indépendante du scaffold et normalise les interactions dans un format de trajectoire commun. Les deux tournent hors du pool GPU préemptible. Si l'entraîneur est préempté, le rollout peut être suspendu et déchargé avec tout son état.
- Fusionner des modèles pour relancer : on fusionne des checkpoints issus d'entraînements sur différents scaffolds ou configurations pour réinitialiser l'entraînement suivant. On combine ainsi des progrès obtenus par des chemins d'optimisation différents, et on gagne en performance et en efficacité en tokens.
16.3 DSec : des millions de bacs à sable
Pour entraîner des agents, il faut des environnements où ils exécutent réellement du code. DSec (DeepSeek Elastic Compute) est la plateforme de sandboxes de DeepSeek. Pour V4.1, la demande est montée à des millions d'instances simultanées.
Cohérence relâchée
Les nœuds sont découpés en shards (« unités d'échelle »), ce qui limite aussi les dégâts d'une expérience gourmande. Au lieu de Kubernetes, un moteur de placement maison tourne en plusieurs répliques indépendantes, sans coordination synchronisée. Chaque nœud valide lui-même les placements et refuse ceux qui dépassent un seuil local.
conteneurs actifs par machine physique, avant dégradation mesurable. On y parvient en liant chaque VM worker à un domaine NUMA via le partitionnement sub-NUMA matériel.
Classe « sensible à la latence »
Pour que les évaluations chronométrées ne soient pas faussées par les voisins, les tâches non prioritaires passent en SCHED_IDLE. Le core scheduling garantit que seules des tâches de même priorité partagent un cœur physique.
Contenir la triche
Des agents ont tenté du reward hacking en exploitant des vulnérabilités récemment divulguées (pilote XFS, AppArmor, fuite de réponses via des miroirs de paquets). D'autres ont supprimé des binaires critiques, voire le système de fichiers. Parades : profils AppArmor par sandbox et politiques réseau eBPF. Un crash compte comme un échec, avec un signal de « répercussion » envoyé au RL.
16.4 Une infrastructure de RL asynchrone
En RL pour LLM, quelques réponses très longues retardent toujours tout le lot : c'est le problème de la longue traîne. La génération est donc devenue asynchrone pour presque toutes les tâches de RL et d'OPD. Rollout et entraînement partagent les mêmes GPU, en temps partagé. Chaque tâche fixe un maximum d'échantillons « en vol ». Reste à décider quand relancer de nouveaux prompts :
Biais de longueur
Les réponses courtes finissent en premier et dominent les premiers lots. Deux parades : limiter la concurrence par jeu de données, et pouvoir jeter les premiers échantillons courts.
Échantillons hors politique
Certains tokens ont été générés par un checkpoint plus ancien. On borne le taux maximal d'échantillons hors politique, et un masque de perte ignore les tokens trop périmés.
Interrompre et reprendre sans perte
La génération s'arrête à n'importe quelle frontière de token. Le cache KV et le routage des experts sont sauvegardés token par token. On reprend avec le nouveau checkpoint sans refaire de prefill, et chaque état est libéré dès que son échantillon est terminé.
Distillation à 40+ professeurs
La dernière étape, l'OPD sur tout le vocabulaire, utilise plus de 40 modèles professeurs, d'architectures parfois différentes. On change de professeur à coût négligeable, et la configuration peut être modifiée en cours de route sans casser les échantillons en vol.
SFT → RL → OPD, sans nouvel algorithme. La performance vient de tâches et environnements synthétisés à grande échelle et vérifiables, de milliers de sandboxes par machine, et d'un RL asynchrone qui absorbe la longue traîne.
Un bouton pour régler l'effort de raisonnement
Le coût d'un modèle ne dépend pas que de son architecture : il dépend aussi du nombre de tokens qu'il écrit. V4.1 apprend à ajuster la longueur de sa réflexion selon un simple nombre entre 1 et 100.
17.1 Le signal d'effort
Pendant le RL, on ajoute en tête du prompt système l'instruction suivante :
Pour chaque prompt d'entraînement x, on échantillonne plusieurs réponses à chaque niveau d'effort b. Les réponses de même (x, b) forment un sous-groupe, dans lequel les récompenses sont centrées pour calculer les avantages relatifs, façon GRPO. On ne compare donc jamais directement deux niveaux d'effort entre eux. Le comportement propre à chaque niveau vient d'une pénalité de longueur qui dépend de b :
Si le bénéfice marginal d'un token de réflexion décroît à peu près exponentiellement, p′(ℓ) ≈ a · exp(−ℓ/s), alors la longueur optimale vaut ℓ*(b) ≈ C − s · log k0 + (s/τ)(b − bmin) : une droite en fonction de l'effort. Les auteurs précisent qu'il s'agit d'une approximation locale. Les longueurs mesurées ne sont pas forcément linéaires, car l'effort peut changer la stratégie de raisonnement elle-même.
17.2 En production
L'API publique, lancée en septembre 2026, propose trois paliers qui correspondent directement à ce réglage. On change de point de fonctionnement sans toucher aux poids ni aux paramètres de décodage :
| Palier API | Effort b |
|---|---|
| max | 100 |
| high | 75 |
| low | 50 |
L'entraînement n'utilise qu'un nombre fini de niveaux, mais les valeurs intermédiaires donnent des comportements interpolés.
17.3 Ce que ça donne
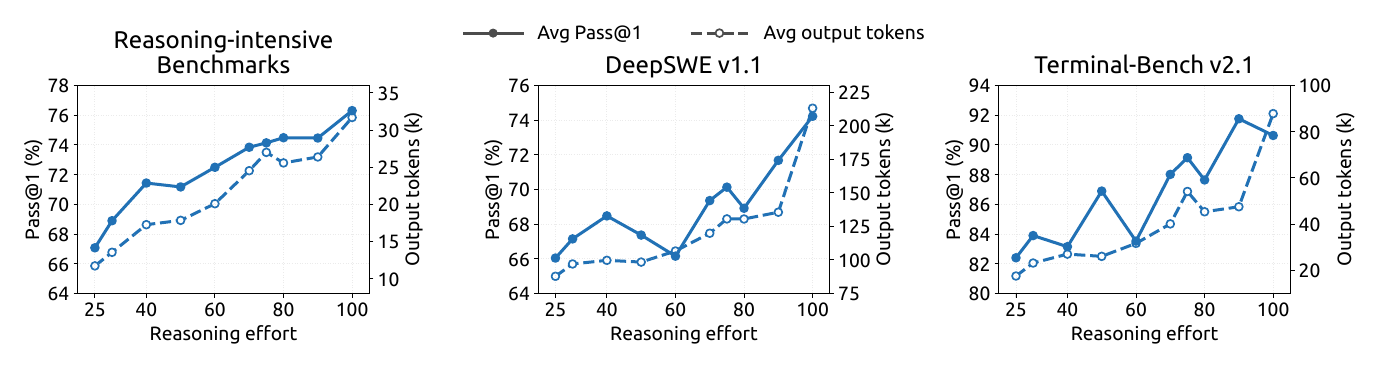
quand l'effort passe de 25 à 100.
la maîtrise de l'effort apprise en réponse unique se transfère aux trajectoires d'agent multi-tours.
pour environ 2,5× plus de tokens de sortie.
Les gains sont concentrés au début. La plage 60–80 récupère déjà l'essentiel de la précision du réglage maximal, pour moins de la moitié de son budget en tokens. La dernière marche vers 100 allonge les trajectoires d'agent de 1,6 à 1,8× pour des gains marginaux. Le palier max est donc à réserver aux tâches les plus difficiles.
L'annexe détaille les huit benchmarks de raisonnement. La longueur croît de façon régulière, de 2,0 à 3,1× entre les efforts 25 et 100 : de 4,6k à 11,4k tokens sur AIME 2026, de 29,1k à 86,1k sur MathArena Apex 2025. La précision ne baisse sur aucun benchmark : +40,3 points sur MathArena Apex 2025 (25,3 → 65,6 %), 100 % sur AIME 2026. Dans les scaffolds de code, en revanche, la longueur augmente toujours avec l'effort, mais le Pass@1 ne suit que de loin, avec des plateaux et des creux.
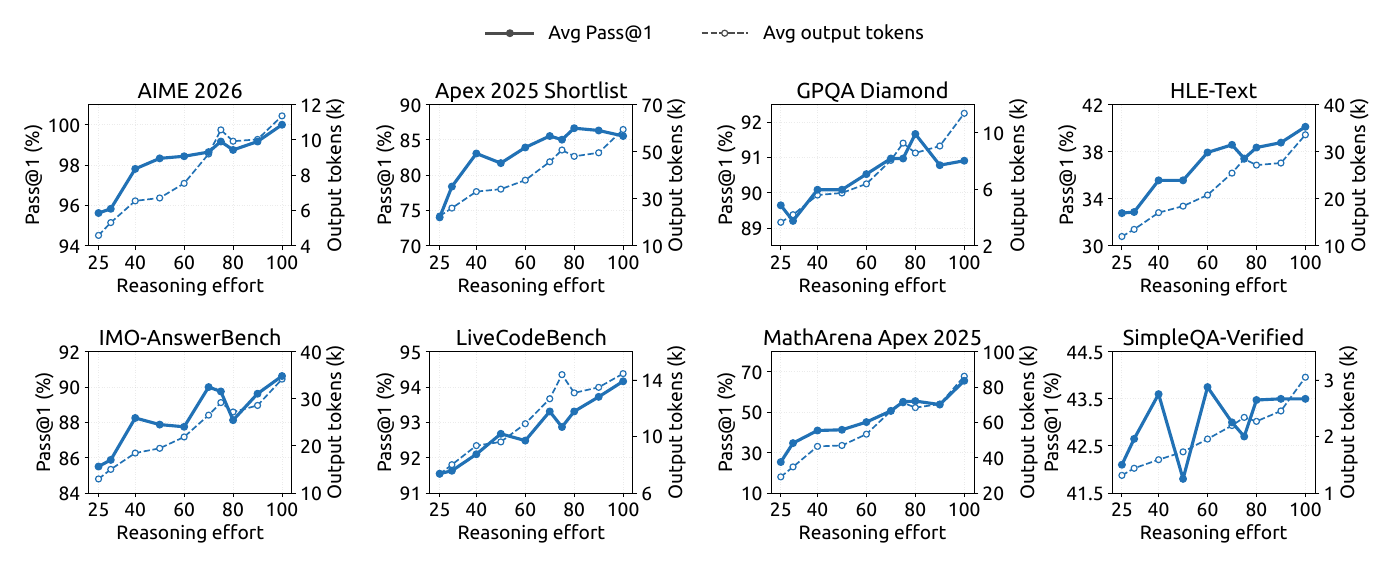
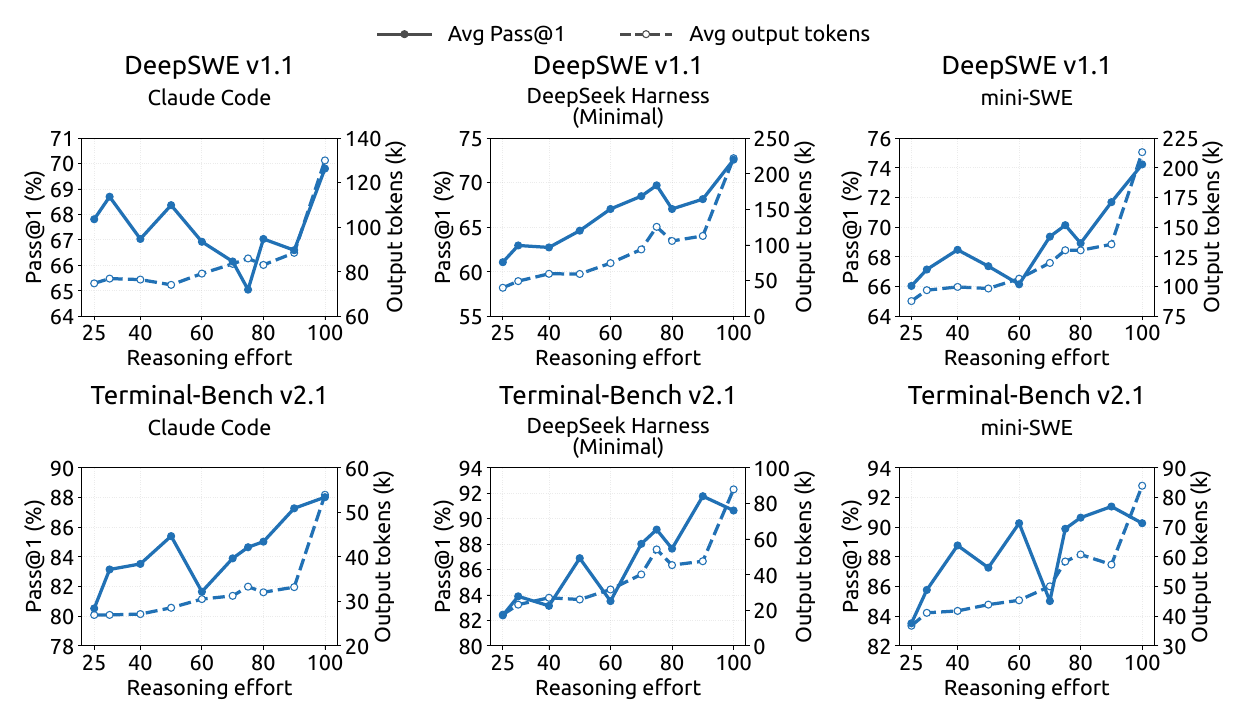
Un seul checkpoint, un seul nombre b : la pénalité de longueur décroît exponentiellement avec l'effort demandé, ce qui produit des longueurs de raisonnement à peu près proportionnelles à l'effort. Les efforts intermédiaires (60–80) offrent le meilleur rapport coût / qualité.
Les résultats : un « Flash » au niveau des modèles fermés
Sur la plupart des benchmarks d'agents, V4.1-Flash rejoint, voire dépasse, les meilleurs modèles fermés du moment. Il reste un écart sur les tâches scientifiques les plus exigeantes.
18.1 Le cadre d'évaluation
- Raisonnement : GPQA Diamond, Humanity's Last Exam (HLE), Codeforces (benchmark interne), MathArena Apex.
- Agents de code : Terminal-Bench 2.1 / 3.0 / 4.0, DeepSWE v1.1, ProgramBench, NL2Repo-Bench. Évalués avec le mode Minimal de DeepSeek Harness, 1M tokens de contexte, température 1,0, top-p 0,95 (mini-SWE pour DeepSWE).
- Cybersécurité : SEC-Bench Pro, CyberGym, ExploitGym.
- Agents généralistes : AutomationBench, Agents' Last Exam.
- Agents visuels : Chartography, BabyVision, ZeroBench (avec le harnais Claude Code, contexte de 512k).
Pour limiter la triche dans les évaluations de code, l'accès à internet est coupé, les historiques Git sont supprimés et les caches de compilation ou de paquets sont purgés. Des comportements de recherche d'exploit ont pourtant été observés, par exemple la décompilation de paquets Ubuntu pour y trouver des vulnérabilités dans CyberGym. Les auteurs appellent la communauté à en tenir compte dans les prochains benchmarks.
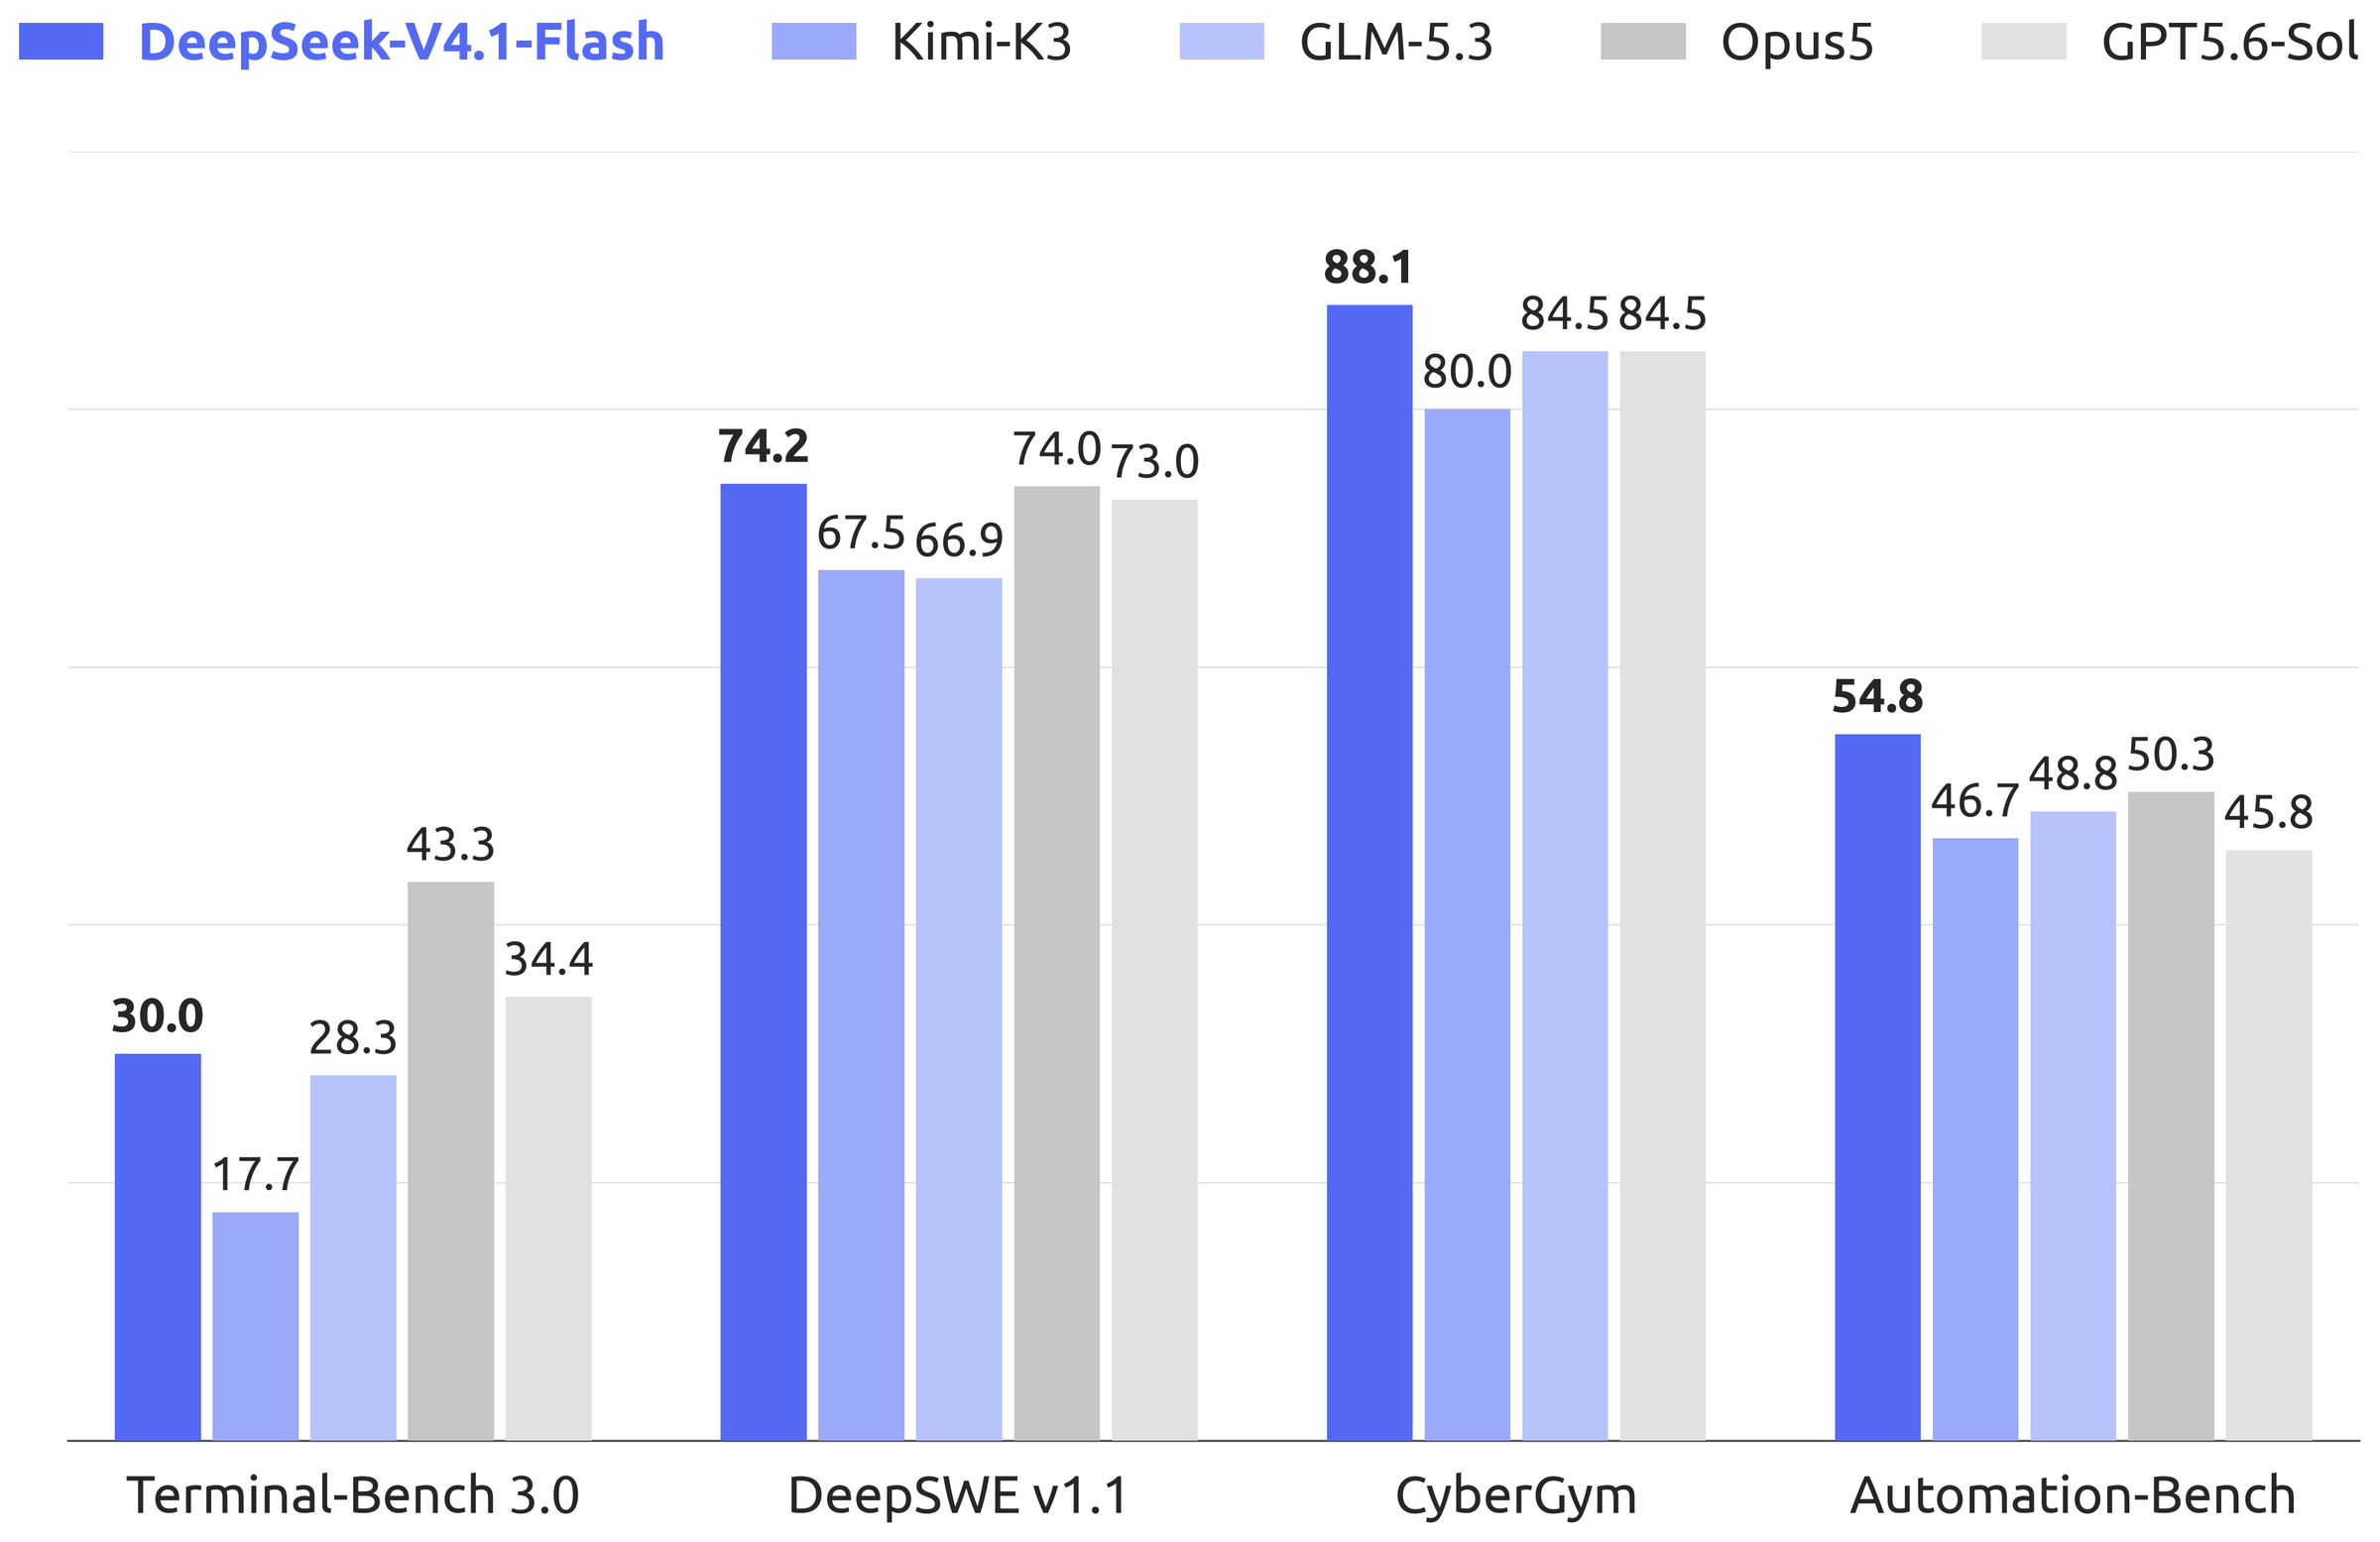
Là où V4.1-Flash mène
Codeforces 3 471 (contre 3 348 pour V4-Pro), DeepSWE 74,2 % (devant Opus-5 à 74,0 % et GPT-5.6 Sol à 73,0 %), Terminal-Bench 2.1 90,6 %, Automation-Bench 54,8 %, Agents' Last Exam 31,8 %, CyberGym 88,1 % (nouvel état de l'art parmi les modèles ouverts en cybersécurité).
Là où l'écart persiste
Les tâches d'agent à forte expertise scientifique : Terminal-Bench 4.0 (31,2 contre 51,8 pour Opus-5), Terminal-Bench 3.0, ProgramBench, HLE sans outils (36,8 contre 56,3), ExploitGym. En vision, V4.1 dépasse Kimi-K3 mais reste derrière les meilleurs modèles fermés.
18.2 Robuste d'un scaffold à l'autre
Un modèle est rarement déployé dans un seul harnais. Les auteurs gardent le même checkpoint, la même configuration de décodage et les mêmes tâches, et ne changent que le scaffold (prompt système, outils, logique des tours) : huit configurations issues de six familles.
Les capacités se transfèrent bien entre familles de scaffolds, ce qui est cohérent avec la diversité des environnements et formats d'outils des données synthétisées. Sur Claude Code, quatre versions testées donnent en moyenne 68,9 % sur DeepSWE et 87,8 % sur Terminal-Bench 2.1 (annexe, tableau 5).
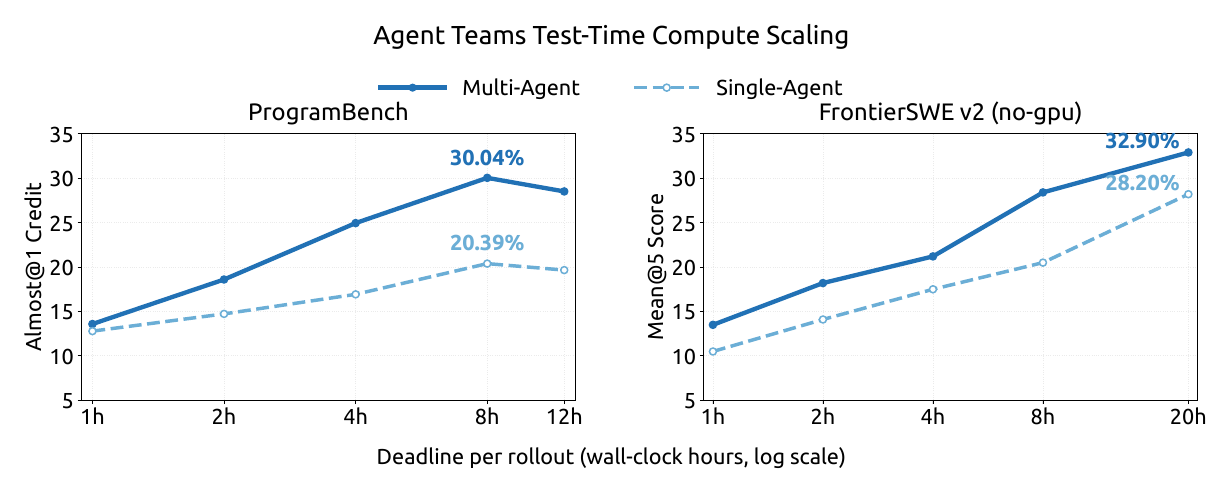
18.3 Travailler en équipe d'agents
Expérience préliminaire : le mode Agent Team de DeepSeek Harness. Un agent chef crée de manière asynchrone des coéquipiers nommés et persistants (spawn_teammate). Chacun démarre soit « à neuf », soit avec une copie de l'historique du chef (fork). Tous partagent le même checkout du dépôt. Ils communiquent par une boîte aux lettres durable (send_message). Le chef surveille l'état de l'équipe (list_agents, wait_agent), peut interrompre un coéquipier (interrupt_agent) et tient un tableau de tâches partagé. À la fin, il relit, teste et livre.
L'entraînement RL combine trois termes : la performance sur la tâche, un bonus de collaboration (déléguer, communiquer) et une pénalité de latence dérivée. Cette latence est la longueur du chemin critique d'un graphe acyclique des événements : les coûts en tokens y sont convertis à des vitesses de prefill/decode fixes, plus le temps mesuré des outils. On encourage ainsi le parallélisme utile et on pénalise l'attente inutile.
Avec 8 à 16 Md de paramètres activés, V4.1-Flash égale ou dépasse les meilleurs modèles fermés du tableau sur la majorité des benchmarks d'agents de code et d'automatisation. Il reste nettement derrière sur les tâches à forte expertise scientifique (Terminal-Bench 3.0 / 4.0, HLE).
Limites et perspectives
Le papier se termine sur une section de limites plutôt franche. Elle vaut la peine d'être lue, car la compression agressive a un prix potentiel.
Les nouveautés d'architecture créent des « frontières de robustesse » pas encore entièrement caractérisées. Les évaluations internes n'ont montré aucune dégradation systématique, mais aucun jeu de tests fini ne couvre tous les cas extrêmes. Les auteurs citent deux risques : des erreurs de sélection dans CSA2 (l'indexeur rate une entrée importante), et la reconstruction approximative du SWA Bounded Replay, qui pourraient dégrader les capacités dans des cas limites non testés.
Les prochaines priorités annoncées :
- étendre les tests de stress, surtout la recherche parcimonieuse sur très longs contextes et la reconstruction SWA aux frontières de reprise du cache ;
- surveiller les charges réelles pour caractériser les modes de défaillance ;
- continuer de faire évoluer les protocoles d'évaluation, car les benchmarks saturent. Des scores proches ne signifient pas des capacités égales aux meilleurs systèmes fermés sur les problèmes les plus durs. Le papier cite Fable-5 et GPT-6 Astra comme références de pointe ;
- faire croître ensemble données, capacité du modèle et RL, et co-concevoir le modèle avec son harnais d'agent (model–harness co-design).
L'ambition affichée : baisser les coûts et augmenter les capacités en même temps, pour rendre des agents très capables plus accessibles et plus faciles à déployer.
Récapitulatif et quiz final
Toutes les innovations du rapport sur une page, puis quelques questions pour vérifier que tout est en place.
| Innovation | Problème visé | Idée | Gain annoncé |
|---|---|---|---|
| CED | Prefill coûteux des agents | Le KV global du décodeur est projeté depuis la sortie de l'encodeur ; seuls les derniers tokens traversent le décodeur | Prefill ≈ ÷2 ; 8 Md activés en prefill contre 16 Md en decode |
| CSA2 | Un cache global par couche | Modes Full / Reindex / Reuse : on partage main KV, indexer K et indices entre couches ; compresseur et indexeur simplifiés | 4 couches sur 38 stockent un KV global ; 2,5 entrées par token |
| Indexeur hiérarchique | Indexeurs qui notent tout le contexte | La couche Full du décodeur choisit un pool de 16 384 candidats ; les couches Reindex ne cherchent que là | Coût des indexeurs profonds constant avec la longueur |
| Main KV en FP4 | Taille des entrées du cache | E2M1 + une échelle E4M3 tous les 16 canaux, sans échelle globale ; QAT en post-entraînement | ≈ ÷2 par rapport au FP8 (288 contre 512 octets par entrée) |
| SWA Bounded Replay | KV SWA stocké pour rien sur SSD | KV SWA dans un pool RAM à courte durée de vie ; reconstruction approximative en rejouant 128 tokens | Cache persistant ≈ ⅛ de V4-Flash |
| Single-Pass mHC | Trafic mémoire des flux résiduels | Utiliser Al−1 pour le mélange d'entrée ; noyau fusionné Mega-mHC | Trafic des activations ÷2 |
| Engram | Mémoriser coûte du calcul | Tables d'embeddings adressées par hachage de N-grammes, préchargées depuis l'hôte | 196 Md de paramètres de mémoire pour un calcul minime |
| DSpark | Decode limité par la mémoire | Brouillon de 5 tokens en une passe, confiance par position, longueur de vérification choisie selon la charge | Accélère le service et les rollouts de RL |
| Effort contrôlable | Coût des tokens de sortie | Pénalité de longueur qui décroît exponentiellement avec l'effort b | Un seul modèle, trois paliers d'API (50 / 75 / 100) |
Pour aller plus loin
- Le rapport technique complet : copie locale (PDF, 51 pages) · sur Hugging Face
- Les checkpoints du modèle : huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash
- Les travaux sur lesquels il s'appuie, cités dans le rapport : YoCo (Sun et al., 2024), mHC (Xie et al., 2026), Engram (Cheng et al., 2026), DSpark (Cheng et al., 2026), DeepSeek-V4 (DeepSeek-AI, 2026).
Ce cours s'appuie uniquement sur le rapport technique DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression (DeepSeek-AI, septembre 2026). Les figures marquées « papier » en sont extraites telles quelles. Les modules marqués « Illustration » simplifient un principe avec des valeurs fictives. Les modules « Interactif » utilisent les chiffres du papier ou des calculs qui en découlent, signalés comme tels. Les passages entre guillemets traduisent brièvement le texte original.