Jev et System One, expliqués pas à pas
Un LLM écrit du texte pour des humains. Jev, le modèle de TypeSafe AI, fait autre chose : on lui envoie un state et des questions typées, il renvoie des réponses structurées, avec des probabilités et un niveau de confiance, que votre code utilise directement. Ce cours part de zéro et construit, notion après notion, jusqu'aux patterns, aux SDK et aux limites connues.
Une requête, trois questions, une réponse typée
Cliquez sur une question pour voir ce que Jev renvoie (exemple du Quick start de la documentation).
jev-1.13.0 ; les tokens de sortie sont gratuitsLes modules marqués Interactif utilisent des valeurs tirées de la documentation (réponses enregistrées de jev-1.13.0, tableaux, exemples de code). Les modules marqués Illustration simplifient un principe avec des valeurs fictives ou un calcul signalé comme tel. La page ne fait aucun appel réseau : elle n'interroge jamais l'API TypeSafe. Les termes de l'API restent en anglais (« state », « Choice », « confidence »…). Quand un point n'est pas documenté, le cours le dit.
Pourquoi un modèle de décision ?
Vous connaissez les LLM par l'usage : on tape une question, on lit une réponse. Mais quand c'est du code qui doit consommer un jugement, le texte devient un obstacle. C'est de ce décalage que part TypeSafe.
- Le décalage entre « produire du texte » et « prendre une décision utilisable par du code ».
- Trois façons d'architecturer un logiciel avec de l'IA : traditionnel, agent, logiciel propulsé par l'IA.
- Ce que Jev promet : des valeurs typées, des probabilités, une confiance.
Le décalage texte / décision
La page d'introduction de la documentation résume le problème en une phrase : les grands modèles de langage sont conçus pour produire du texte que des humains lisent. Dès qu'on veut qu'un modèle rende un jugement que le code va consommer (« ce ticket est-il urgent ? », « quel service doit le traiter ? »), on force un système de génération de texte à sortir une décision structurée, puis on re-parse le résultat pour en faire quelque chose dont le code peut dépendre.
Chacun a déjà écrit ce genre de code : un prompt qui supplie le modèle de « répondre uniquement par un JSON valide », une expression régulière pour récupérer la valeur, un try/except pour le jour où le modèle ajoute une phrase de politesse. Et même quand le JSON est propre, il manque une chose : à quel point le modèle est sûr. Un LLM peut écrire « urgent » avec le même aplomb qu'il s'agisse d'une évidence ou d'un coup de dés.
Ce que Jev fait à la place
Jev est le modèle phare de TypeSafe et le premier modèle dit System One. Il évalue des questions typées contre un state (le contenu à juger) et renvoie des résultats structurés : pas de génération de texte, pas de parsing. Le code reçoit des valeurs typées et des distributions de probabilités sur lesquelles il peut brancher, trier, router. Les questions de type Choice et Score renvoient en plus une « confidence », un nombre entre 0 et 1 que le code utilise pour décider s'il agit, et comment.
Trois architectures logicielles
La page How to build with TypeSafe place Jev dans un paysage à trois cases. Il faut bien comprendre laquelle Jev vise, parce que ce n'est pas celle des agents.
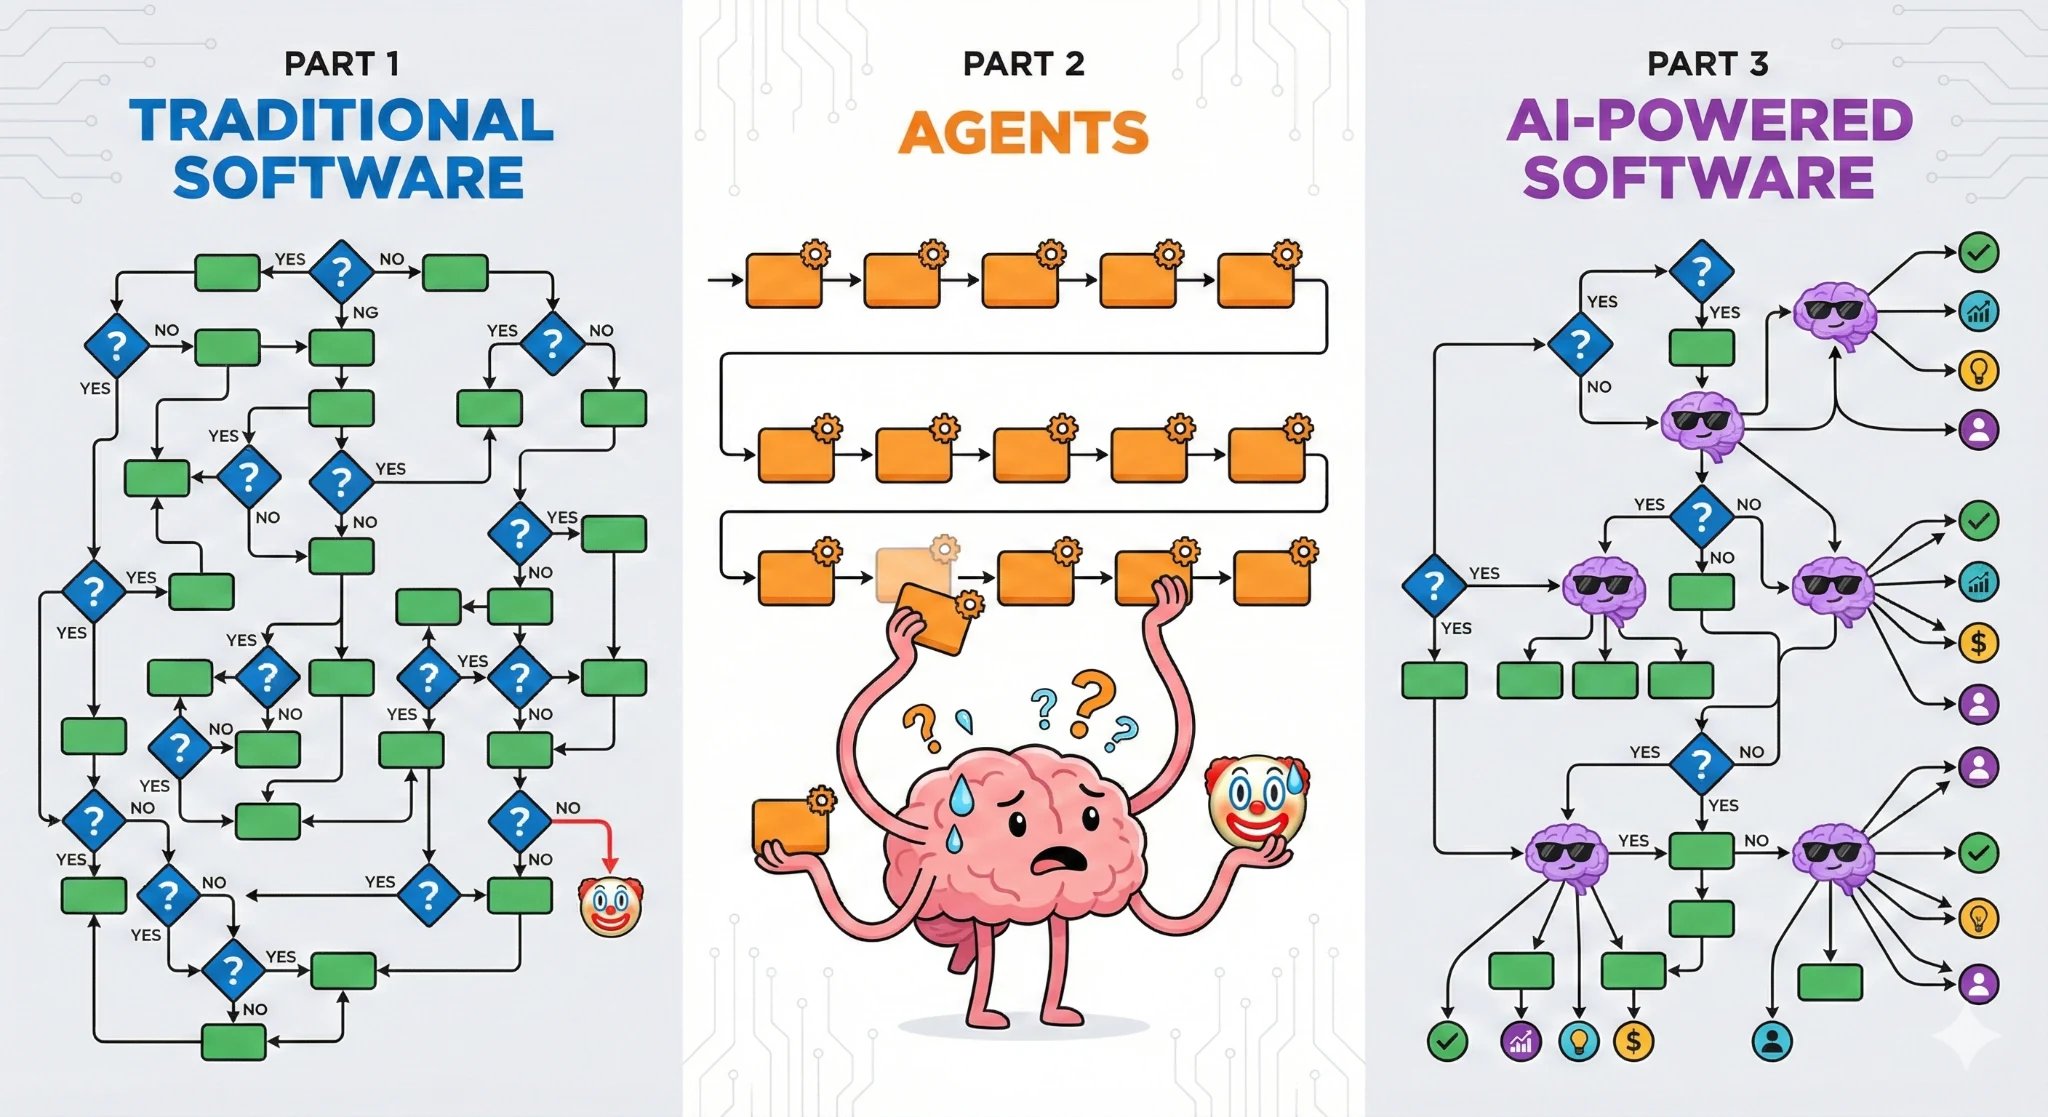
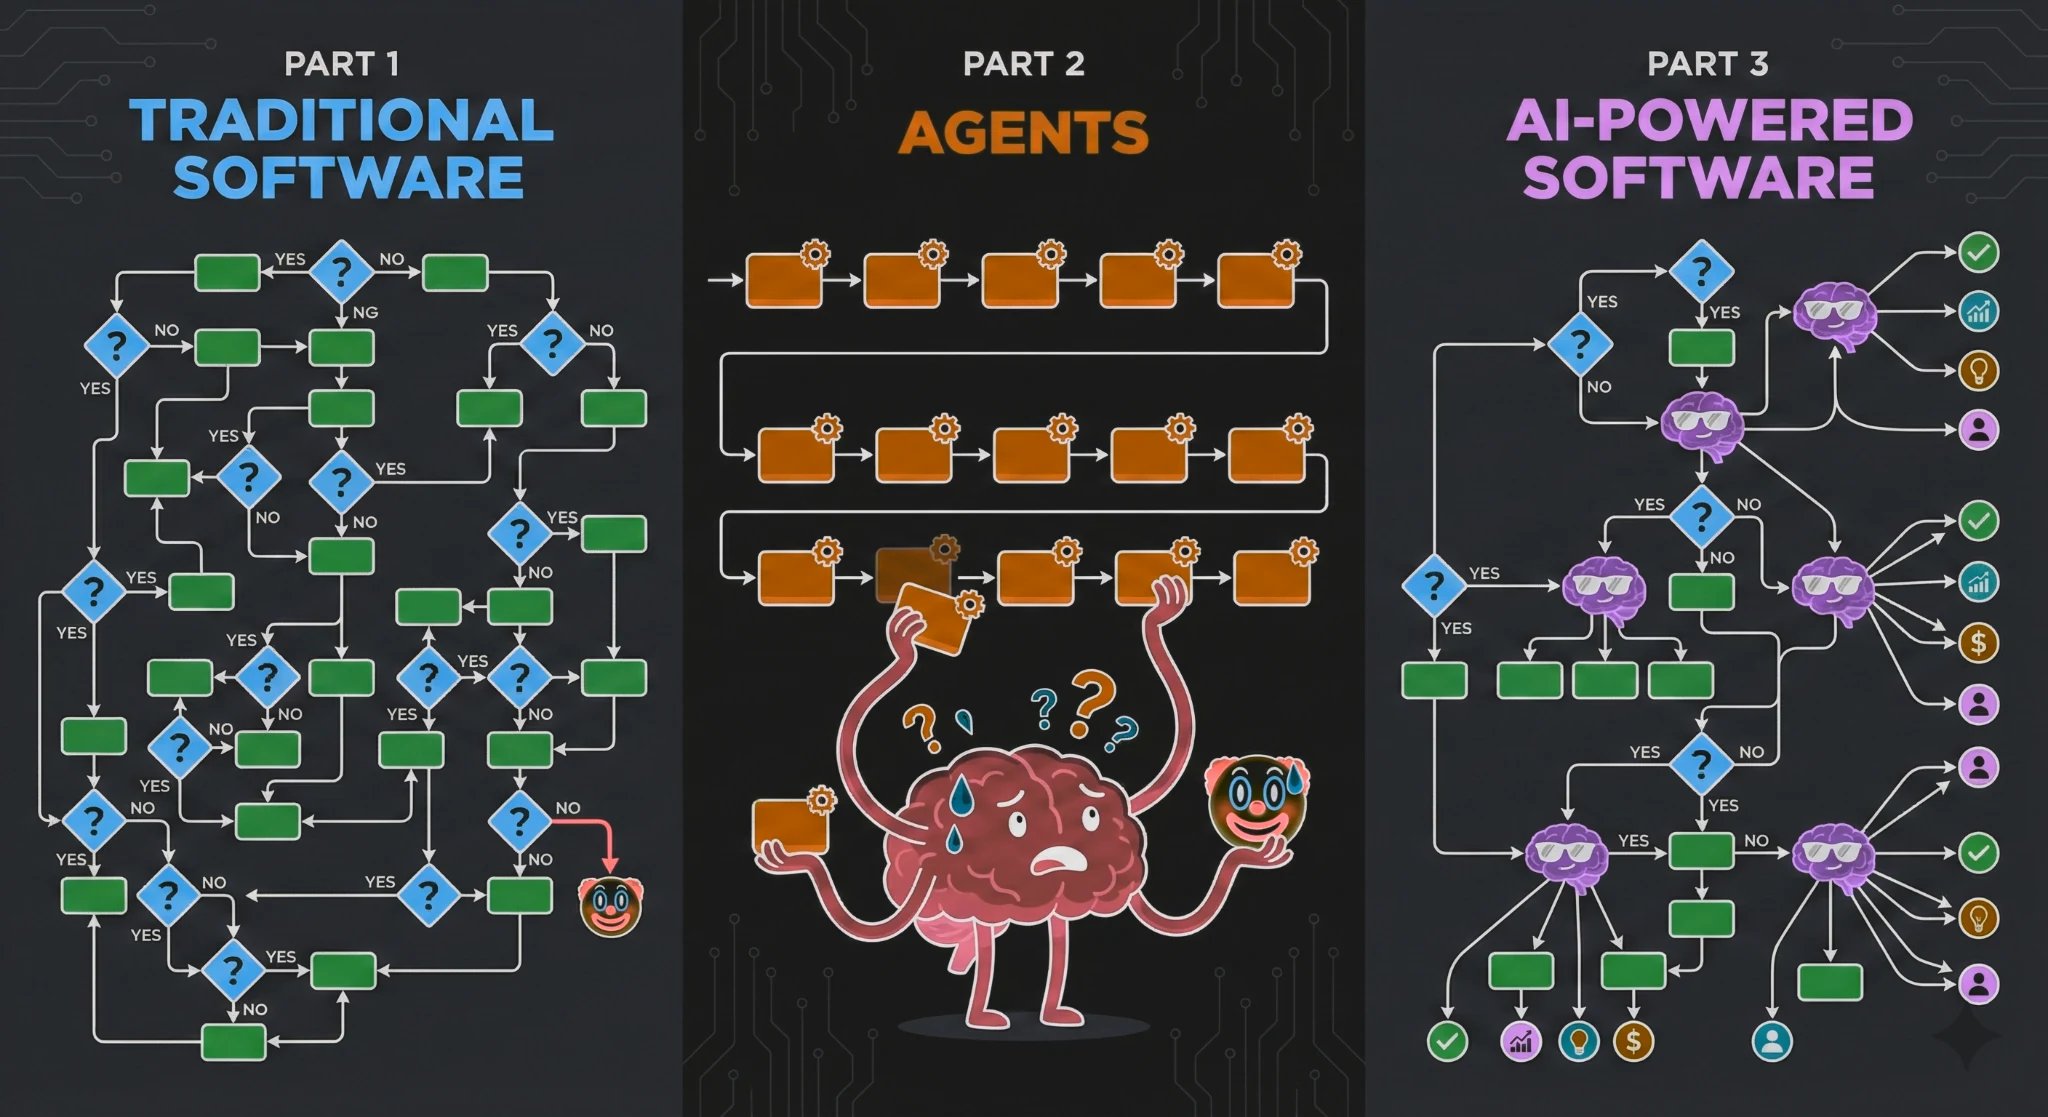
/concepts/how-to-build-with-system-one) : le logiciel traditionnel, les agents LLM et le logiciel propulsé par l'IA, vus comme trois architectures différentes.Jev est conçu pour construire du logiciel propulsé par l'IA, pas des agents. Il ne génère pas de code, ne choisit pas sa prochaine action, ne rédige rien. Il fournit des primitives d'IA qui s'emboîtent dans un programme ordinaire : le code garde le contrôle du flux, le modèle rend des jugements de bon sens sur des données non structurées.
System One : l'idée et l'entraînement
D'où vient le nom, ce que « calibré » veut dire, et pourquoi TypeSafe a inventé un troisième chemin de post-entraînement à côté du RLHF et du RLVR.
- System 1 / System 2 : des jugements rapides, pas du raisonnement long.
- Calibration : une probabilité de 0,8 doit se vérifier 80 % du temps, sur un ensemble de prédictions.
- RLHF, RLVR, RLCD : trois objectifs d'entraînement, trois types de modèles.
Le nom vient de Kahneman
La page System One l'explique : le nom reprend le concept popularisé par Daniel Kahneman dans Thinking, Fast and Slow. Le Système 1 est rapide et intuitif ; le Système 2 est lent et délibéré. Jev se place résolument dans le premier : des jugements rapides et ciblés, le genre de chose qu'une personne compétente décide en une seconde quand on lui donne le bon contexte.
C'est une règle de conception autant qu'un nom. « Ce message exprime-t-il de l'urgence ? » est une bonne question. « Analyse ce message et détermine la meilleure marche à suivre » n'en est pas une : cela demande un raisonnement lent, et la documentation y voit le signal qu'il faut découper la tâche en petites questions, puis composer les réponses dans le code.
Comme un LLM, un modèle System One comprend le langage naturel en entrée. Contrairement à un LLM, il renvoie des décisions typées et des probabilités, pas du texte. Deux limites documentées : Jev accepte uniquement du texte (chaînes, objets JSON, tableaux de textes ; ni image, ni audio, ni vidéo « pour l'instant »), et sa langue principale d'entraînement est l'anglais, les autres langues étant acceptées avec une précision moindre.
Calibré : ce que cela veut dire, et ce que cela ne garantit pas
Le mot revient partout dans la documentation : Jev est entraîné pour des décisions calibrées. Ses probabilités sont optimisées contre des résultats réels pour refléter l'incertitude. Concrètement, sur un grand nombre de prédictions d'un modèle bien calibré :
- les issues auxquelles il attribue une probabilité de
0.2se produisent environ 20 % du temps ; - celles à
0.8, environ 80 % du temps ; - celles à
1.0, 100 % du temps.
La documentation ajoute aussitôt la nuance qui compte : ces taux décrivent des groupes de prédictions. La calibration ne garantit rien sur une réponse prise isolément. Une confiance de 1,0 décrit la réponse du modèle, pas une preuve qu'elle est juste.
Trois chemins de post-entraînement
L'AI primer de la documentation pose le pari de TypeSafe : l'automatisation à grande échelle sera dominée par des interactions IA-vers-IA et IA-vers-logiciel, à peu près « 99 % machine-à-machine et 1 % humain ». L'interface machine compte donc plus que l'interface de chat. TypeSafe appelle cela Machine Native Intelligence : une IA avec des propriétés de logiciel, structure, fiabilité, observabilité, testabilité, vitesse, constance, faible coût. La formule de la page : « Building prod, not God », construire pour la production, pas un modèle qui fait tout.
Apprentissage par retour humain
A transformé les modèles pré-entraînés en chatbots : ils apprennent à produire les réponses que les gens préfèrent. La page rappelle que le RLHF a été co-inventé par Diogo Almeida, cofondateur de TypeSafe.
Récompenses vérifiables
A produit les modèles de raisonnement, forts en mathématiques par exemple, mais plus lents et plus chers.
Décisions calibrées
Le chemin de TypeSafe : Reinforcement Learning for Calibrated Decisions. Le modèle ne génère pas de texte ; il renvoie des décisions et des probabilités, et une probabilité plus haute doit correspondre à une plus grande chance d'avoir raison.
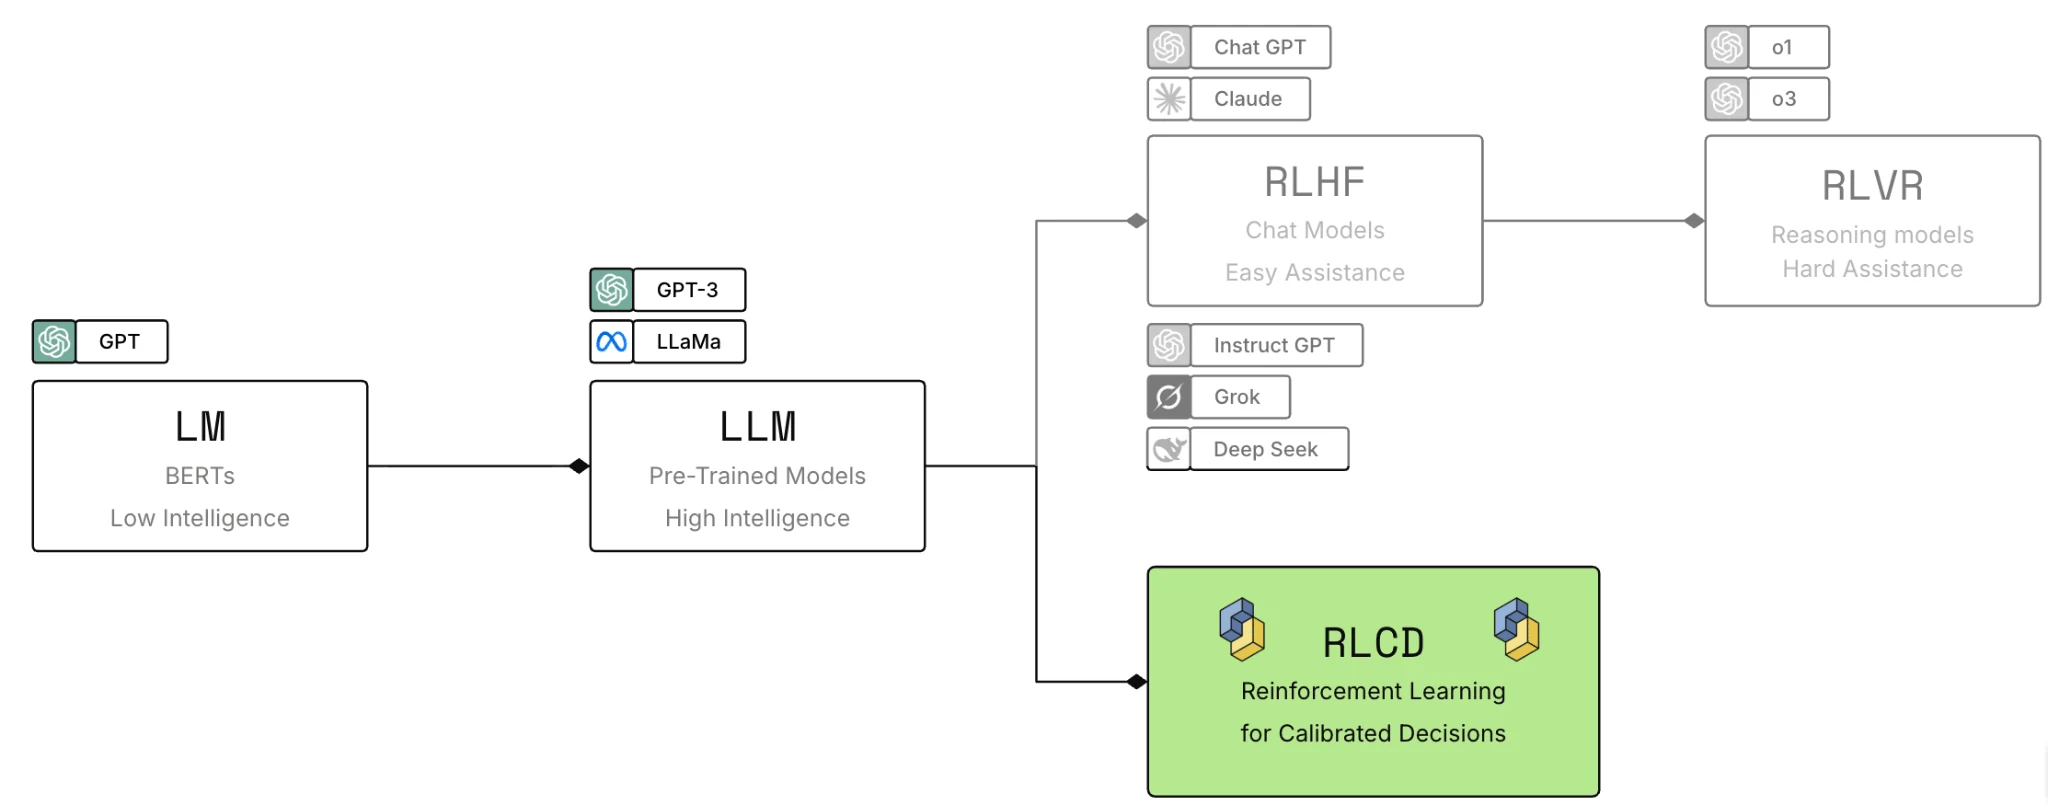
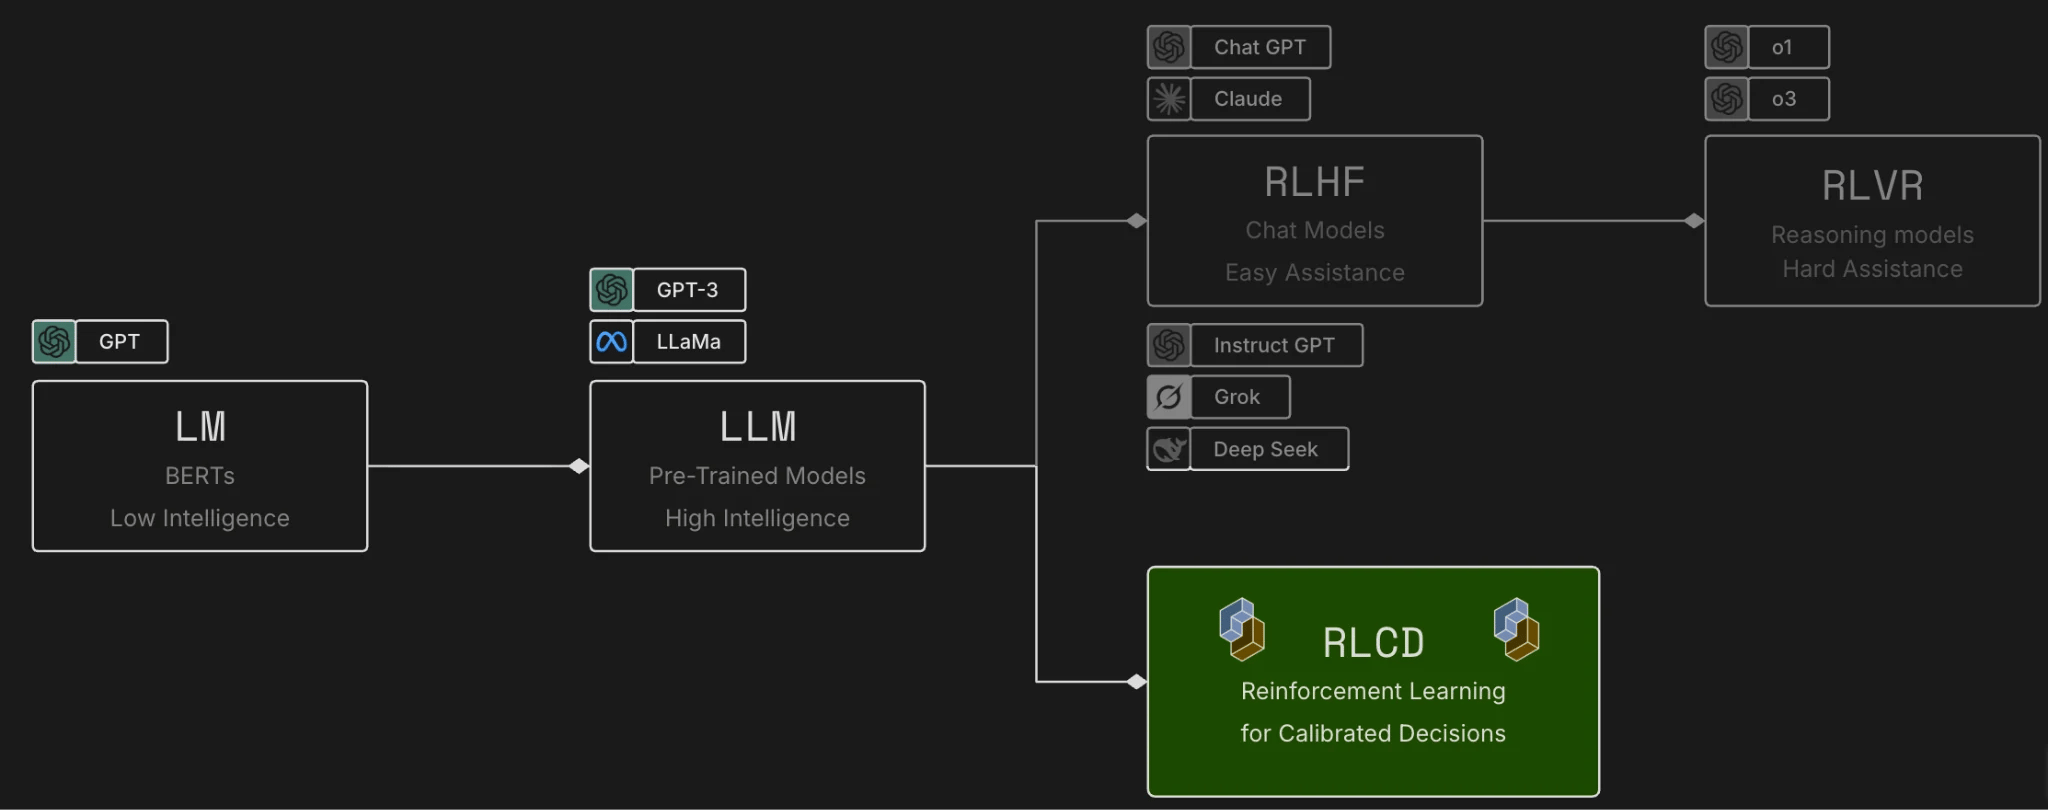
/introduction/machine-learning-primer) : à partir d'un modèle de langage pré-entraîné, les chemins RLHF et RLVR en retrait, et le chemin RLCD vers un modèle de décision mis en avant.Le problème du RLHF, vu par TypeSafe
Le RLHF apprend à un modèle à dire ce que les gens préfèrent. Cet objectif marche bien pour un chatbot, mais il peut aussi récompenser la flagornerie et les hallucinations dites avec assurance. L'optimisation des préférences provoque aussi ce que la page appelle le mode dropping : le modèle apprend à favoriser un style (suivre les instructions, par exemple) et réduit la probabilité des autres sorties possibles. C'est une version atténuée du mode collapse des GAN, où un générateur finit par produire toujours le même type de sortie parce qu'elle continue à tromper le discriminateur.
La conclusion de la page est mesurée : le RLHF reste un bon choix pour les modèles conversationnels. Mais une sortie peut être convaincante pour une personne sans être assez fiable pour une automatisation sans surveillance. Préférence humaine et fiabilité machine sont deux cibles d'optimisation différentes ; l'automatisation en production demande, selon TypeSafe, un objectif centré sur des décisions contraintes et une incertitude calibrée.
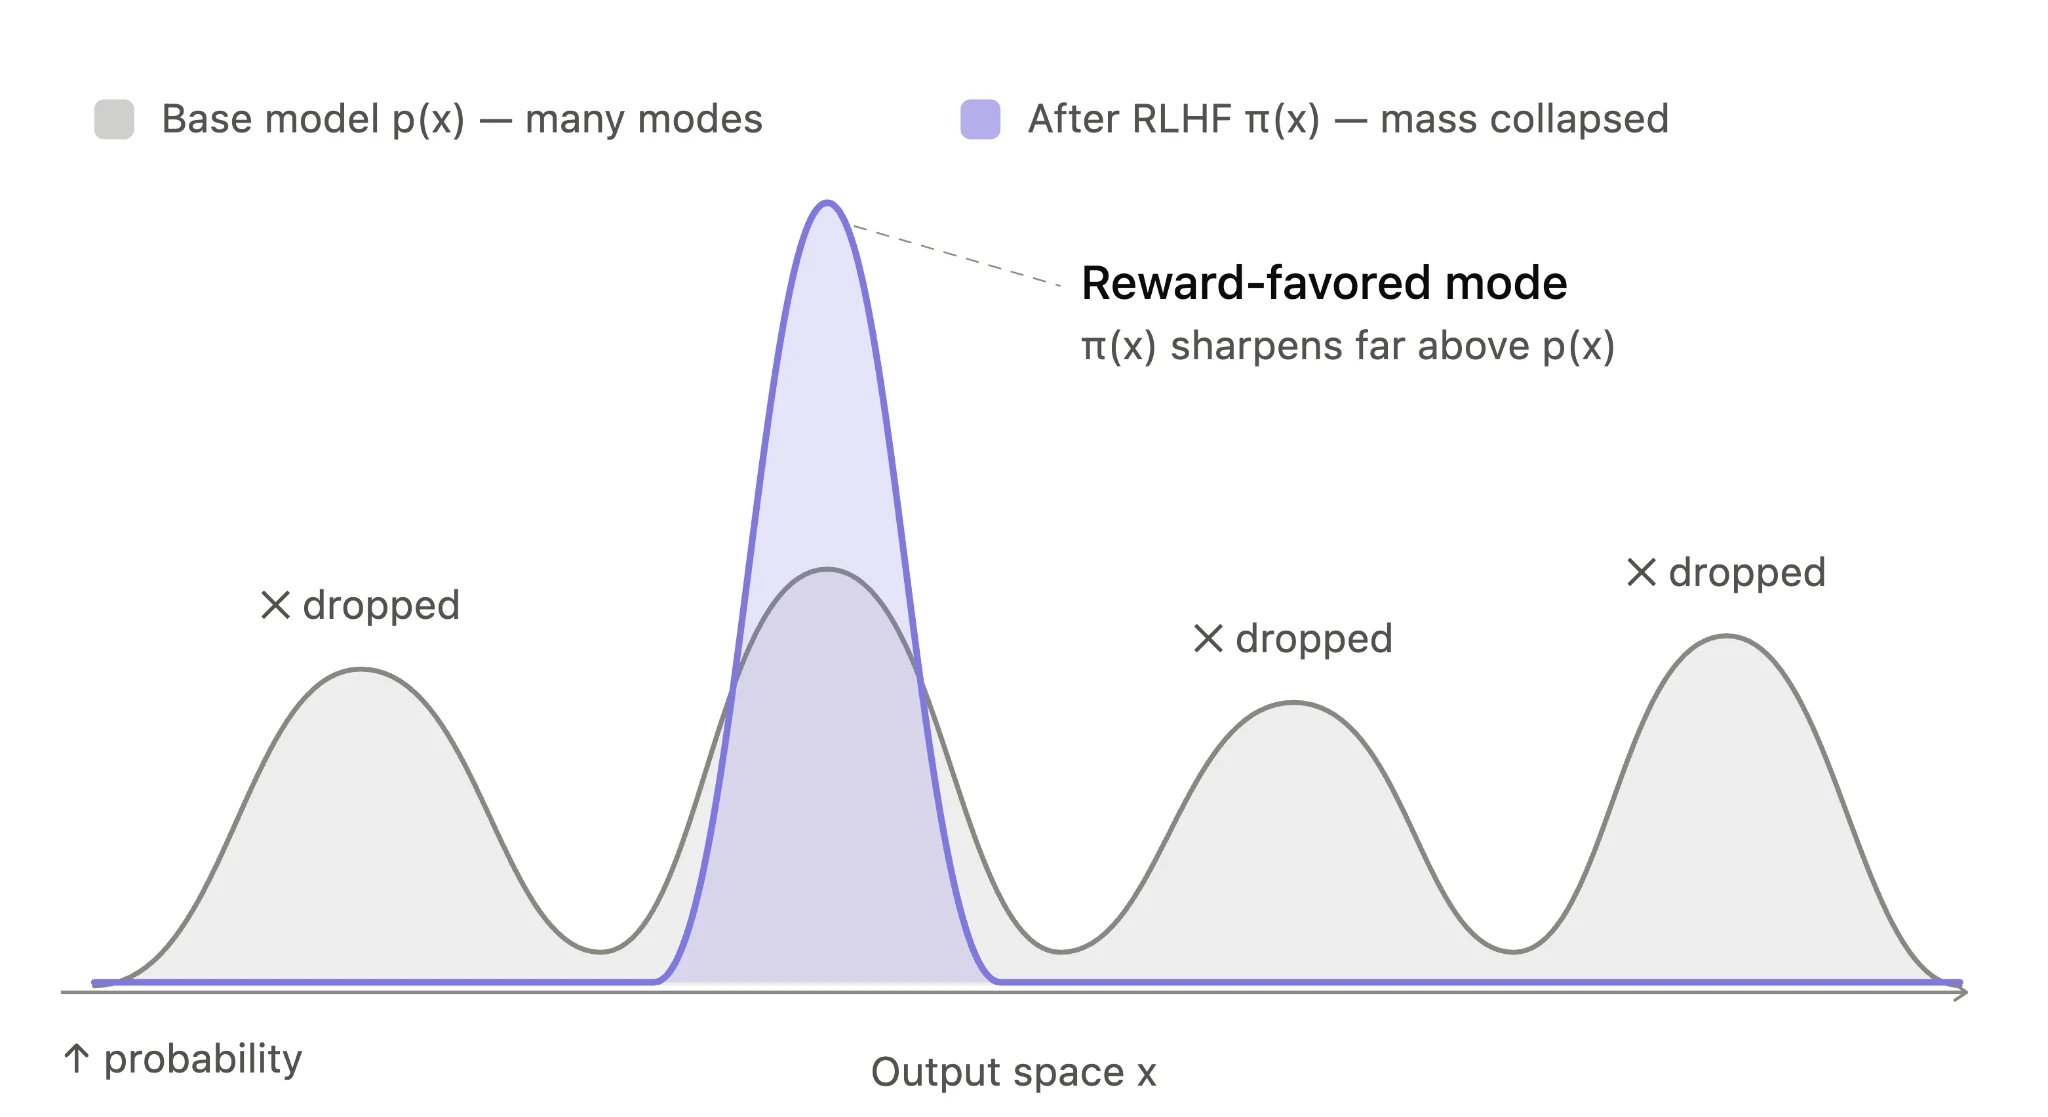
La documentation décrit l'objectif du RLCD (décisions + probabilités calibrées) mais pas la recette d'entraînement : ni les données, ni la fonction de récompense, ni l'architecture de Jev, ni sa taille. Le cours n'invente rien là-dessus. La page Models précise seulement que Jev n'est ni fine-tuné ni adapté par LoRA avec des données client : les mêmes poids servent tous les comptes, et l'adaptation au domaine passe par la requête (state, instructions, criteria).
Anatomie d'une requête et d'une réponse
Avant de détailler chaque type de question, regardons la forme d'un échange complet avec l'API : trois champs en entrée, une réponse par question en sortie.
- Les trois champs de toute requête :
state,model,questions. - Les identifiants de questions : choisis par vous, jamais vus par le modèle.
- La réponse :
model,answers,usage.
Une requête
Tout passe par un seul point d'entrée, POST https://api.typesafe.ai/v1/systemone, avec une clé d'API en en-tête Authorization: Bearer. Le corps JSON a toujours la même forme de haut niveau :
state: le contenu à évaluer. Une chaîne, un objet ou un tableau (chapitre 4).model: le modèle qui traite la requête, par exemple"jev-latest"(chapitre 17).questions: une map d'objets question. Vous choisissez chaque clé ; les réponses reviennent sous les mêmes clés.
Chaque question a un type (choice, score ou noul), des instructions (la question posée) et, selon le type, des criteria (les options, les niveaux, ou la définition du oui et du non).
La documentation le répète sur chaque page de primitive : la clé que vous choisissez (department, is_urgent…) sert à votre code pour retrouver la réponse. Le modèle ne la voit pas. Écrivez donc la question complète dans instructions, même quand l'identifiant semble parler de lui-même.
Une réponse
La réponse contient trois champs : model, l'identifiant versionné du modèle qui a répondu (par exemple jev-1.13.0, même si vous avez demandé jev-latest) ; answers, une entrée par question, sous vos identifiants ; et usage, le nombre de tokens en entrée et en sortie. Chaque réponse porte un type qui correspond au type de la question, puis des champs propres au type :
| Type | Ce qu'il répond | Champs renvoyés | Comment le lire |
|---|---|---|---|
| Choice | Laquelle de ces options ? | choice, probabilities, confidence | choice est l'option la plus probable ; probabilities la distribution sur toutes les options ; confidence résume à quel point cette distribution est piquée. |
| Score | Quel niveau ? | score, legend, probabilities, confidence | score est une position le long de vos niveaux, qui peut tomber entre deux ; legend rappelle les niveaux par numéro. |
| Noul | Est-ce vrai ? | noul | La probabilité que la réponse soit oui. Près de 1 : oui franc ; près de 0 : non franc ; près de 0,5 : incertain. Pas de confidence séparée. |
Deux propriétés rendent ces réponses composables, et la documentation les met en avant :
- Chaque réponse est contrainte aux options fournies. Le modèle renvoie une distribution sur vos options ou niveaux, jamais une valeur en dehors. Le code n'a jamais à récupérer une valeur dans de la prose.
- Chaque réponse est indépendante. La réponse à une question n'est pas un contexte caché pour une autre. On peut ajouter ou retirer des questions sans changer les résultats des autres.
curl -X POST https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d @- <<'EOF'
  {
    "state": "Hi, I've been trying to connect my Stripe account for 3 days and the integration keeps failing. I'm losing sales. Please help ASAP.",
    "model": "jev-latest",
    "questions": {
      "urgency": {
        "type": "noul",
        "instructions": "Does this message express urgency?"
      }
    }
  }
EOF"is_urgent" dans la map questions ?Le « state » : ce qu'on donne à juger
Le state est la matière première : un message, un passage, ou l'état courant de votre application. La documentation conseille de le structurer, de n'y mettre que le nécessaire, et de pointer les questions vers ses parties par des chemins.
- Trois formats : chaîne, objet, tableau, et quand utiliser chacun.
- Séparer le contenu (state) des jugements (questions).
- Référencer un champ précis avec un chemin entre accents graves :
`ticket.messages[0].text`.
Chaîne, objet ou tableau
Le state le plus simple est une chaîne : "My card was charged twice.". Mais il peut aussi être un objet ou un tableau JSON contenant du contexte, des exemples, des enregistrements liés. L'image proposée par la page State : pensez au state comme au dossier que vous présenteriez à un panel d'experts avant de leur demander un jugement.
| Format | Utile pour | Exemple (doc) |
|---|---|---|
| Chaîne | Un message, un article, un passage | "My card was charged twice." |
| Objet | Des champs nommés, des enregistrements liés, l'état de l'application | {"message": "My card was charged twice.", "order_id": "A-104"} |
| Tableau | Une séquence de messages ou d'enregistrements | ["Hi", "My customer number is TS1337.", "My card was charged twice."] |
Le conseil de la documentation : utilisez un objet pour la plupart des requêtes, pour que chaque partie du state porte un nom descriptif et que ses relations restent claires. La chaîne convient quand le cas est simple et ne demande qu'un seul texte. Une requête évalue un state contre une ou plusieurs questions ; toutes les questions voient le même state et sont évaluées indépendamment.
Séparer le contenu des questions
Le state contient le contenu et les faits d'appui ; les questions définissent les jugements à porter dessus. L'exemple de la doc : gardez la demande de remboursement et la politique de remboursement dans le state, puis demandez d'un côté si le client demande un remboursement, de l'autre si la politique le permet. Deux Nouls, un seul state.
Référencer un champ précis
Quand le state est un objet à plusieurs parties, une question porte souvent sur l'une d'elles. La page Primitives demande de la nommer dans les instructions avec un chemin « point et index » vers sa clé, accents graves compris : `ticket.messages[0].text`, `order.charges`. Le modèle sait alors quelle partie du state juger.
questions = {
    "refund_requested": {
        "type": "noul",
        "instructions": "Does `ticket.messages[0].text` request a refund?",
    },
    "policy_supports_refund": {
        "type": "noul",
        "instructions": (
            "Does `refund_policy` support the refund requested "
            "in `ticket.messages[0].text`, given `order.charges`?"
        ),
    },
}Décomposez l'entrée : n'incluez que le contexte utile aux questions posées. Cela évite les distractions et ce que la doc appelle le context rot, la perte de précision quand le state grossit avec du contenu sans rapport. Ne comptez pas sur la mémoire du modèle : quand une information à jour existe dans votre base de connaissances, mettez-la dans le state plutôt que d'espérer qu'elle soit dans les poids.
Choice : choisir une option parmi un ensemble
La première primitive. Vous donnez la liste des options possibles ; Jev renvoie celle qu'il retient, une probabilité pour chacune, et une confiance.
- Quand utiliser un Choice : une réponse parmi un ensemble fixe, sans ordre entre les options.
- La forme de la question (
criteria= map option → description) et de la réponse. - Lire une distribution partagée entre deux équipes, et ce que fait le code avec.
Quand
Un Choice sert quand la réponse est l'une d'un ensemble fixe d'options : quelle équipe traite un ticket, à quelle catégorie appartient un produit, dans quel langage est écrit un extrait de code. Si la réponse est une position sur un spectre, c'est un Score ; si c'est oui ou non, un Noul. Exemples de questions donnés par la page :
- « What programming language is this code written in » →
python, javascript, typescript, go, rust, other - « What type of meeting is this based on the title and description » →
standup, planning, retrospective, one on one, brainstorm, none of the above - « Which product category does this item belong to » →
electronics, clothing, home garden, food and beverage
Notez les options other et none of the above : la doc recommande d'en ajouter une quand la liste pourrait ne pas couvrir toutes les entrées, pour que le modèle puisse dire qu'aucune ne convient.
La forme
Un Choice a trois champs : type (toujours "choice"), instructions (la question) et criteria, une map dont chaque clé est un nom d'option et chaque valeur une description. Les noms et les descriptions sont tous deux envoyés au modèle : écrivez des descriptions qui séparent les options les unes des autres. Une description peut être null quand le nom se suffit (exemple de la doc : {"calm": None, "frustrated": None, "angry": None}). Un Choice accepte jusqu'à 255 options.
from typesafe_sdk import Choice, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state="My running shoes arrived in the wrong size. Can I swap them for a size 10?",
        questions={
            "department": Choice(
                instructions="Which team should handle this?",
                criteria={
                    "returns": "Exchanges, wrong or damaged items",
                    "shipping": "Delivery status, delays, lost packages",
                    "billing": "Charges, invoices, payment problems",
                },
            ),
        },
    )

    print(response.answers["department"].choice)
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";
const client = new TypeSafeClient();
const response = await client.systemOne({
state: "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
questions: {
department: choice("Which team should handle this?", {
returns: "Exchanges, wrong or damaged items",
shipping: "Delivery status, delays, lost packages",
billing: "Charges, invoices, payment problems",
}),
},
});
console.log(response.answers.department.choice);{
"state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
"model": "jev-latest",
"questions": {
"department": {
"type": "choice",
"instructions": "Which team should handle this?",
"criteria": {
"returns": "Exchanges, wrong or damaged items",
"shipping": "Delivery status, delays, lost packages",
"billing": "Charges, invoices, payment problems"
}
}
}
}Lire une réponse partagée
Dans l'exemple à cinq questions, department revient returns à 0,61, mais billing a 0,35 à cause d'un double débit mentionné dans le ticket. Le ticket appartient à deux équipes, et la confiance de 0,42 reflète ce partage. La question requested_resolution est encore plus indécise : refund 0,40, replacement 0,34, exchange 0,24, confiance 0,20 ; le client ne dit pas ce qu'il veut. Le code de la doc en tire trois conséquences :
- sous 0,3 de confiance sur
department, on n'assigne pas : une personne trie ; - une seconde équipe qui a plus de 0,25 de probabilité reçoit une copie ;
- sous 0,5 de confiance sur
requested_resolution, on demande au client au lieu de deviner.
def triage(ticket: str) -> None:
    with TypeSafeClient() as client:
        response = client.system_one(
            state=ticket,
            questions=TRIAGE_QUESTIONS,
        )
    answers = response.answers

    department = answers["department"]
    if department.confidence < 0.3:
        # Not clear which team to send to. Let a person decide.
        send_to_manual_triage(ticket)
        return

    if department.choice == "returns":
        # return_reason answer is only used here
        assign(ticket, team="returns", issue=answers["return_reason"].choice)
    elif department.choice == "shipping":
        # shipping_issue answer is only used here
        assign(ticket, team="shipping", issue=answers["shipping_issue"].choice)
    else:
        assign(ticket, team="billing")

    # A second team with a real share of the probability gets a copy
    for team, probability in department.probabilities.items():
        if team != department.choice and probability > 0.25:
            notify(ticket, team=team)

    resolution = answers["requested_resolution"]
    if resolution.confidence < 0.5:
        # The customer hasn't said what they want. Ask, don't guess.
        ask_customer_what_they_want(ticket)
    elif resolution.choice == "refund":
        flag_for_refund_approval(ticket)

    if answers["tone"].choice == "angry":
flag_for_senior_agent(ticket)if ordinaireDeux des cinq questions sont spéculatives : return_reason ne compte que si le service est returns, shipping_issue que s'il est shipping. On les pose quand même, parce que les questions sont évaluées en parallèle et que le code ignore ce dont il n'a pas besoin. Si demain il faut la langue du client ou le produit concerné, on ajoute un Choice : le nombre de requêtes reste à un. C'est le pattern Speculative fan-out du chapitre 12.
Descriptions structurées
Commencez par une ligne de description par option. Quand deux options se ressemblent et que le modèle les confond, la doc conseille de décrire chacune par un objet plutôt qu'une chaîne : un champ pour ce que l'option couvre, un pour ce qui appartient à l'option voisine, quelques exemples. Les noms de champs (what, not_for, examples, question, focus…) ne font pas partie de l'API et ne sont pas réservés : vous les choisissez, le modèle les voit avec les valeurs, donc préférez des noms courts qui étiquettent ce qui suit. L'exemple de la doc oppose return_policy et return_status, deux options qui parlent toutes deux de retours ; avec des objets contrastés, la réponse est return_status à confiance 1,0.
criteria d'un Choice, qu'est-ce que le modèle voit ?Score : situer le state sur des niveaux ordonnés
La deuxième primitive répond à « quel niveau ? ». Vous décrivez des paliers, du plus bas au plus haut ; Jev renvoie une position, qui peut tomber entre deux, plus une probabilité par niveau.
- Les niveaux : un tableau ordonné de descriptions, numérotées 0, 1, 2… par leur position.
score= moyenne des numéros de niveaux pondérée par leurs probabilités.- Écrire de bons niveaux, et découper un jugement composite en plusieurs Scores.
Quand
Un Score sert quand la réponse est une position sur un spectre que vous pouvez décrire par paliers : la gravité d'un bug, la satisfaction d'un client, l'expérience Python d'un candidat. Chaque entrée de criteria est un niveau, décrit en mots. Le numéro d'un niveau est sa position dans le tableau à partir de 0 : trois entrées font les niveaux 0, 1 et 2. Il faut au moins deux niveaux ; l'API en accepte jusqu'à 10.
Détail important donné par la page : le modèle reçoit les descriptions et rien d'autre, et chaque niveau est jugé séparément contre le state. Il ne voit ni le numéro du niveau ni ses voisins. « Pire que le niveau précédent » ne veut donc rien dire pour lui.
from typesafe_sdk import Score, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state="The export button crashes the settings page in Safari. It works in Chrome, but a few of our customers only use Safari.",
        questions={
            "bug_severity": Score(
                instructions="How severe is the reported issue?",
                criteria=[
                    "Cosmetic; no impact to functionality",
                    "Broken or degraded feature, but workaround exists",
                    "Blocking issue; no workaround exists",
                ],
            ),
        },
    )

    print(response.answers["bug_severity"].score)
import { score, TypeSafeClient } from "@typesafe-ai/sdk";
const client = new TypeSafeClient();
const response = await client.systemOne({
state: "The export button crashes the settings page in Safari. It works in Chrome, but a few of our customers only use Safari.",
questions: {
bug_severity: score("How severe is the reported issue?", [
"Cosmetic; no impact to functionality",
"Broken or degraded feature, but workaround exists",
"Blocking issue; no workaround exists",
]),
},
});
console.log(response.answers.bug_severity.score);{
"model": "jev-1.13.0",
"answers": {
"bug_severity": {
"type": "score",
"score": 1.43,
"confidence": 0.35,
"legend": {
"0": "Cosmetic; no impact to functionality",
"1": "Broken or degraded feature, but workaround exists",
"2": "Blocking issue; no workaround exists"
},
"probabilities": { "0": 0.0, "1": 0.57, "2": 0.43 }
}
},
"usage": { "input_tokens": 332, "output_tokens": 18 }
}Dans le troisième et le quatrième exemple, la probabilité se partage entre les niveaux 1 et 2. Plus de poids sur le 2 fait monter le score, mais il ne mesure pas la fraction de clients sans contournement. Et des distributions différentes peuvent donner le même score : 1,0 peut vouloir dire « tout sur le niveau 1 » ou « moitié sur le 0, moitié sur le 2 ». Lisez probabilities et confidence à côté du score pour les distinguer. La page Jaggedness ajoute : ne vous servez pas du score pour reconstituer une grandeur exacte entre deux niveaux ; un seuil, oui, une interpolation, non.
Écrire de bons niveaux
- Décrivez des situations, pas des degrés. « Fonction cassée ou dégradée, mais un contournement existe » donne au modèle quelque chose à comparer au state. « Modérément grave » ne donne rien.
- Pas de chiffres. Avec
criteria: ["0", "1", "2"]et l'instruction « Rate severity from 0 to 2 », le rapport du bouton mal aligné obtient 0,55 à confiance 0,33 (probabilité partagée entre 0 et 1). Avec les trois niveaux descriptifs, il obtient 0,0 à confiance 1,0. - Autant de niveaux que vous pouvez décrire distinctement, jusqu'à 10. Trois, c'est bien. N'ajoutez pas de niveau que vous ne savez pas distinguer.
- Une dimension par Score. « Ponctuel et brillant et expérimenté » mesure trois choses ; une entrée haute sur l'une et basse sur l'autre ne peut pas être placée, la confiance chute, le score perd son sens. Séparez et combinez dans le code.
- Donnez son propre niveau à un cas extrême rare sur lequel vous devez agir différemment : une échelle de sentiment qui finit à « très en colère » peut ajouter « abusif ou menaçant ».
- Testez sur vos données. Deux formulations de la même échelle peuvent se comporter différemment. Une confiance plus haute ne prouve pas à elle seule qu'une description est meilleure.
Découper un jugement complexe en plusieurs Scores
Un jugement qui dépend de plusieurs choses se découpe en un Score par chose, envoyés dans la même requête (ils sont évalués en parallèle, cela coûte quelques tokens de question). Le code combine ensuite les scores avec des poids qui lui appartiennent. L'exemple de la doc : la priorité d'un ticket à partir de trois Scores, gravité (3 niveaux), frustration (3 niveaux) et qualité du rapport (4 niveaux). Comme les échelles n'ont pas la même longueur, on normalise chaque score en le divisant par son numéro de niveau maximal, len(criteria) - 1, pour tout ramener entre 0 et 1.
def normalized(answers, question_id: str) -> float:
    """Put a score on 0 to 1 by dividing by its top level number."""
    top_level = len(TRIAGE_QUESTIONS[question_id].criteria) - 1
    return answers[question_id].score / top_level

def priority(ticket: str) -> float:
    with TypeSafeClient() as client:
        response = client.system_one(
            state=ticket,
            questions=TRIAGE_QUESTIONS,
        )
    answers = response.answers

    severity = normalized(answers, "severity")
    frustration = normalized(answers, "frustration")
    report_quality = normalized(answers, "report_quality")

    # A detailed report helps an engineer investigate, so it raises priority a little.
    return 0.6 * severity + 0.3 * frustration + 0.1 * report_quality
Niveaux structurés
Quand le modèle continue à placer entre deux niveaux voisins des entrées qui vous paraissent claires, donnez à chaque niveau un objet : un champ pour ce que le niveau couvre, un autre avec quelques situations d'exemple, les mêmes noms de champs sur tous les niveaux. Le tableau de la doc sur le rapport Safari est éloquent :
| Description des niveaux | score | confidence |
|---|---|---|
| Chaînes simples, sans objet ni exemple | 1,43 | 0,35 |
| Objets avec un exemple utile : « export fails in one browser but works in another » | 1,03 | 0,96 |
| Objets avec un exemple sans rapport : « search fails, but browsing categories still works » | 1,43 | 0,35 |
L'exemple qui ressemble aux vraies entrées concentre presque toute la probabilité sur un niveau ; l'exemple sans rapport ne change rien. Et la mise en garde de la page : une confiance plus haute n'établit pas quelle réponse est correcte. Choisissez des exemples dont vous connaissez le niveau attendu, puis testez les descriptions révisées sur d'autres entrées avant de les garder.
criteria: ["0", "1", "2"] est-il une mauvaise idée pour un Score ?Noul : la probabilité que la réponse soit oui
La troisième primitive est la plus simple en apparence : une question fermée, un nombre entre 0 et 1. Sa subtilité tient dans ce que ce nombre mesure, et dans le seuil que votre code choisit.
- Un Noul renvoie
noul, la probabilité du oui. Pas deconfidenceséparée, et pourquoi. - Le seuil dépend du coût de l'erreur ; les valeurs du milieu peuvent aller à une personne.
- Un Noul n'est pas une échelle : « Is the candidate strong in Python? » ne mesure pas l'expérience.
Quand
Un Noul sert quand la réponse est oui ou non : ce message demande-t-il un remboursement, ce CV mentionne-t-il les systèmes distribués, ce commentaire contient-il des données personnelles. Les champs : type ("noul"), instructions (la question, ou une affirmation à juger) et, en option, criteria, un objet avec des descriptions true et false de ce que signifient un oui et un non.
from typesafe_sdk import Noul, NoulCriteria, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        model="jev-latest",
        state="I have asked three times now. Can I please just talk to a real person?",
        questions={
            "is_human_escalation": Noul(
                instructions="Is the customer asking for a human agent?",
            ),
            "is_repeat_contact": Noul(
                instructions="Has the customer contacted support about this before?",
                criteria=NoulCriteria(
                    true="Mentions a prior attempt, ticket, or that they have asked before",
                    false="No sign of any previous contact",
                ),
            ),
        },
    )

    print(response.answers["is_human_escalation"].noul)
    print(response.answers["is_repeat_contact"].noul)
import { noul, TypeSafeClient } from "@typesafe-ai/sdk";
const client = new TypeSafeClient();
const response = await client.systemOne({
state: "I have asked three times now. Can I please just talk to a real person?",
questions: {
is_human_escalation: noul("Is the customer asking for a human agent?"),
is_repeat_contact: noul("Has the customer contacted support about this before?", {
true: "Mentions a prior attempt, ticket, or that they have asked before",
false: "No sign of any previous contact",
}),
},
});
console.log(response.answers.is_human_escalation.noul);
console.log(response.answers.is_repeat_contact.noul);{
"model": "jev-1.13.0",
"answers": {
"is_human_escalation": { "type": "noul", "noul": 0.99 },
"is_repeat_contact": { "type": "noul", "noul": 0.93 }
},
"usage": { "input_tokens": 360, "output_tokens": 39 }
}Lire un Noul : la réponse et la certitude en un seul nombre
Près de 1, un oui franc. Près de 0, un non franc. Près de 0,5, le modèle donne au oui et au non une probabilité voisine. Il n'y a pas de confidence séparée, contrairement à Choice et Score : la distribution d'un Noul n'a que deux issues, donc la seule valeur noul la décrit complètement. La page donne six messages enregistrés pour la question « Is the customer asking for a human agent? » ; le module ci-dessous les reprend.
YES = 0.8
NO = 0.2

def route(message: str) -> None:
    with TypeSafeClient() as client:
        response = client.system_one(
            model="jev-latest",
            state=message,
            questions=SUPPORT_QUESTIONS,
        )
    answers = response.answers

    wants_human = answers["is_human_escalation"].noul
    repeat = answers["is_repeat_contact"].noul

    if NO < wants_human < YES or NO < repeat < YES:
        # The model isn't sure either way. Let a person decide.
        send_to_review(message)
        return

    priority = "high" if repeat > YES else "normal"
    if wants_human > YES:
        route_to_agent(message, priority=priority)
    else:
route_to_bot(message, priority=priority)La règle de la page : cela dépend du coût de l'erreur. 0,5 quand oui et non sont aussi faciles à assumer l'un que l'autre. Plus haut quand agir sur un faux oui coûte cher (appeler quelqu'un d'astreinte, rembourser). Plus bas quand rater un vrai oui coûte cher (ne pas signaler un problème de sécurité). Et les valeurs du milieu peuvent aller à une personne plutôt qu'à l'un des deux chemins de code. Si les relecteurs voient trop de messages, on resserre l'écart entre NO et YES ; si trop de mauvais routages passent, on l'élargit.
Un Noul n'est pas une échelle
La valeur va de 0 à 1, mais ce n'est pas une mesure de la chose demandée : c'est la probabilité que la réponse soit oui. Si la question est en réalité une question de degré, la valeur ne mesure pas le degré. La doc compare, sur quatre candidats, le Noul « Is the candidate strong in Python? » et un Score à quatre niveaux (aucune expérience, quelque familiarité, usage régulier au travail, expertise profonde) :
On pourrait, dans le code, découper l'intervalle 0–1 en tranches (« 0,3 à 0,7 = quelque expérience »), mais le modèle ne les verrait pas : rien dans sa réponse n'a été jugé contre elles. Une valeur médiane peut vouloir dire « expérience moyenne » ou « cas flou », et l'espacement entre candidats n'est pas quelque chose que vous avez choisi. Avec le Score, chaque candidat atterrit sur ou près d'un niveau que vous avez écrit, et si vous n'êtes pas d'accord, vous reformulez un niveau et relancez.
Écrire une question Noul
- Une question par Noul. « Le client est-il en colère et demande-t-il un remboursement ? » force le modèle à juger deux choses à la fois. Deux Nouls, combinés dans le code.
- Une valeur haute doit vouloir dire oui. « Does the message contain personal data? » est clair. « Is the message free of personal data? » inverse le sens et le code qui le lit se trompera.
- Une affirmation marche aussi bien. Pour « The customer is requesting a refund », une valeur près de 1 signifie que l'affirmation est vraie. Essayez les deux sur vos données.
- Rendez la frontière nette. « Does this candidate have any Python experience? » ne laisse pas de milieu. Quand la frontière est subtile, ajoutez
criteriaavectrueetfalse; sinon l'instruction suffit souvent.
Instructions structurées, questions générées par le code
Les instructions peuvent être un objet : la question dans un champ, des données de référence dans les autres. L'exemple de la page compare un CV qui vient d'arriver à des fiches d'une base de candidats, une question Noul par fiche, toutes dans une seule requête, avec l'identifiant de la fiche dans la clé de la question. Réponses rapportées : la fiche 18 (nom orthographié différemment, même ville, même employeur) obtient 0,74 ; la fiche 42 (même nom, autre ville, autre employeur) 0,09 ; la fiche 77 (nom proche, même lieu, autre employeur) 0,08.
SAME_PERSON = "Is the resume for the same person as `potential_duplicate`?"

def duplicate_questions(candidates: list[dict]) -> dict[str, Noul]:
    """One Noul per candidate record, all asking the same question."""
    return {
        f"same_as_record_{candidate['id']}": Noul(
            instructions={
                "potential_duplicate": {
                    "name": candidate["name"],
                    "location": candidate["location"],
                    "last_employer": candidate["last_employer"],
                },
                "question": SAME_PERSON,
            },
        )
        for candidate in candidates
    }

def find_duplicates(resume: dict, candidates: list[dict]) -> list[str]:
    with TypeSafeClient() as client:
        response = client.system_one(
            model="jev-latest",
            state={"resume": resume},
            questions=duplicate_questions(candidates),
        )
    return [
        question_id
        for question_id, answer in response.answers.items()
        if answer.noul > 0.7
]confidence ?Choisir le bon type, et structurer quand il le faut
Trois primitives, donc trois formes de réponse. La règle de la documentation tient en une phrase : prenez celle dont la réponse est directement actionnable par votre code. Puis, quand une chaîne ne suffit plus, mettez de la structure JSON dans les questions.
La règle
- Choice quand la réponse est une option d'un ensemble connu, sans ordre entre elles. Donnez la liste complète, plus
othersi elle peut ne pas tout couvrir. - Score quand la réponse tombe sur un spectre dont vous pouvez décrire chaque point.
- Noul pour un oui/non net où la probabilité elle-même est le signal utile.
Si deux types semblent convenir, préférez celui dont la réponse s'utilise directement : un Choice entre refund, rebook et information se branche sur trois chemins de code ; un Score de frustration se compare à un seuil ; un Noul se branche sur un if.
Où la structure est acceptée
La page Advanced: structure dit que les modèles System One sont entraînés à comprendre la structure, et liste les champs qui l'acceptent. Chacun est un EntryType : string, object, array ou null.
| Champ | S'applique à | Forme acceptée |
|---|---|---|
instructions | Choice, Score, Noul | string, object, array ou null |
valeurs de criteria (descriptions d'options) | Choice | idem |
entrées de criteria (descriptions de niveaux) | Score | idem |
criteria.true et criteria.false | Noul | idem |
Quand structurer
La page How to build donne trois situations : la question a besoin de contexte ou d'exemples (une longue phrase de contexte ou une liste d'exemples va dans des champs nommés à côté de la question, que le code peut modifier sans réécrire la question) ; une partie de la question vient du code (une valeur lue en base va dans son propre champ plutôt que dans un template de chaîne) ; plusieurs questions ont des instructions voisines (des données supplémentaires les rendent distinctes). Une question courte et sans ambiguïté reste une chaîne.
Un tableau marche aussi, quand l'instruction est une liste de choses à vérifier ou à comparer :
"instructions": {
  "question": "Does the claimed sender identity conflict with the sending domain?",
  "compare": ["ticket.sender.display_name", "ticket.sender.email"],
  "focus": "Compare the named organization with the email domain."
}
Parcourir une taxonomie avec des Choices
Pour classer dans une taxonomie profonde, la doc propose un Choice par niveau, en parcourant l'arbre dans le code : à chaque étape, les options sont les enfants du nœud courant, et la valeur de chaque option est le sous-arbre de l'enfant. Le modèle voit ainsi ce qui vit sous une branche avant de s'y engager, ce qui compte quand l'article appartient à une feuille dont le nom ne se devine pas depuis la branche. L'exemple : une gourde qui peut aller sous Sporting Goods > Cycling > Bike Bottles & Cages ou Home & Kitchen > Drinkware > Water Bottles ; les probabilities disent si le partage est assez serré pour explorer les deux branches. Si un sous-arbre est trop gros, on le réduit à ses enfants directs et à un échantillon de feuilles.
« Confidence » : la forme de la distribution, en un nombre
Toute réponse Choice ou Score contient probabilities. La forme de cette distribution dit à quel point le modèle est sûr ; confidence la résume en un nombre de 0 à 1 pour que le code puisse poser un seuil sans faire le calcul.
- Concentrée sur une issue = confiante ; étalée = incertaine.
confidenceest dérivée deprobabilities; la doc ne publie pas la formule et vous laisse libre d'en calculer une autre.- « Je ne sais pas » est un signal utile : c'est ce qui rend un système fiable.
Dérivée des probabilités
La page Confidence le dit sans détour : confidence est une statistique calculée à partir de la distribution que la réponse contient déjà. TypeSafe la calcule et la renvoie sur chaque Choice et chaque Score, donc le cas courant ne demande rien de plus. Pour un Choice, la distribution porte sur vos options ; pour un Score, sur vos niveaux. Dans les deux cas, plus elle est plate, plus la confiance est basse : sur un Choice, aucune option ne l'emporte nettement ; sur un Score, les niveaux sont ambigus, la question mesure plusieurs choses, ou le state ne dit pas assez.
La documentation présente confidence comme « un défaut solide » qui convient à la plupart des cas, mais précise que vous n'êtes jamais enfermé dans sa définition : selon ce que vous évaluez, une autre mesure peut mieux servir, et c'est pour cela que la réponse contient les probabilities complètes. Les avantages et inconvénients des différents calculs sont renvoyés à un futur cookbook. Le module ci-dessous n'invente donc pas de formule : il montre les couples (distribution, confiance) tels que la doc les rapporte, et une mesure de concentration pédagogique clairement signalée comme telle.
« Je ne sais pas » est un signal utile
La phrase de la page vaut la peine d'être citée : si un système intelligent, humain ou machine, ne peut pas exprimer une incertitude honnête, on ne peut pas lui faire confiance. La confiance est le mécanisme intégré par lequel le modèle dit « pas sûr pour celui-là ». C'est ce qui permet au code d'avoir des comportements différents selon le degré de certitude, et c'est, selon TypeSafe, le fondement des systèmes sur lesquels on peut réellement s'appuyer.
Retenez aussi la limite : une confiance de 1,0 signifie que la distribution renvoyée met toute la probabilité sur une issue. Elle décrit la réponse du modèle, pas une garantie qu'elle soit juste.
confidence d'une réponse Choice ?Agir, confirmer, escalader : les seuils suivent le risque
La réponse dit quoi ; la confiance dit s'il faut agir. Un point de départ : trois plages. Puis une règle : un seuil n'est pas un nombre unique, il dépend des conséquences de l'erreur.
Trois chemins
- Confiance haute : agir automatiquement. Le modèle a une lecture claire.
- Confiance moyenne : avancer avec prudence. Demander confirmation à l'utilisateur, signaler pour relecture, ou collecter plus d'information avant d'agir.
- Confiance basse : ne pas agir. Router vers une personne, demander une clarification, ou basculer sur un autre système. Le modèle dit qu'il manque d'information ou que la question lui convient mal.
Où tracer ces frontières dépend des enjeux. Et dans un même système, des actions différentes doivent être gardées à des niveaux différents. La page Confidence-gated routing le montre avec une interface bancaire vocale : consulter un solde à 0,6 de confiance, c'est acceptable (au pire, l'utilisateur entend un solde qu'il n'a pas demandé) ; approuver un virement demande plus de 0,85, sinon on fait confirmer.
action = response.answers["intent"]

# Below 0.6 confidence on any action, route to a human
if action.confidence < 0.6:
    route_to_support_agent(account_id)

elif action.choice == "check_balance":
    # Low stakes. 0.6 confidence is sufficient.
    show_balance(account_id)

elif action.choice == "approve_transfer":
    if action.confidence > 0.85:
        # High stakes, but high confidence. Safe to act automatically.
        approve_transfer(account_id)
    else:
        # High stakes, moderate confidence. Verify intent first.
        ask_user_to_confirm("Just to confirm: you would like to approve this transfer, is that correct?")

else:
route_to_support_agent(account_id)Les bonnes valeurs dépendent de votre domaine et des performances du modèle sur votre cas. La doc conseille de commencer prudent, tester sur vos données, ajuster en observant les résultats, et de vérifier les seuils en traçant la confiance contre l'exactitude sur vos propres exemples. La page Agent skill ajoute un garde-fou : si tout ce qui vous intéresse est de prendre la meilleure option, prenez simplement l'option la plus probable, sans seuil de confiance ; et si vous avez un algorithme statistique précis en tête, travaillez plutôt sur les probabilités.
Construire avec System One : le code garde la main
La page How to build with TypeSafe est le guide de conception. Son résumé : construisez un flux logiciel normal et insérez System One seulement là où l'IA est nécessaire. Voici ses huit étapes, puis l'exemple complet qui les met bout à bout.
- Ce qui rend System One composable : structuré, parallèle, comparable, rapide, calibré, constant.
- Les huit étapes de conception d'un flux, de « utilisez du code quand vous le pouvez » à « routez sur l'incertitude ».
- Le triage de tickets complet de la doc, avec son score de spam pondéré.
Typé par construction : décisions et probabilités respectent les types et le schéma JSON que le code attend. Il n'a jamais à récupérer une valeur dans de la prose.
Les questions sont évaluées indépendamment et en parallèle. Le résultat d'une primitive ne devient pas un contexte caché qui change le résultat d'une autre.
Les sorties se trient et alimentent des if intelligents, des seuils, des comparaisons.
La plupart des requêtes se terminent en environ 100 ms : assez pour un chemin de requête temps réel ou une interface.
Le RLCD communique l'incertitude par des probabilités calibrées, au lieu de tendre vers l'excès de confiance.
Conçu pour renvoyer des réponses stables d'une évaluation à l'autre (voir le cookbook Self-consistency, chapitre 19).
La page ajoute une cible : un rapport intelligence / (vitesse et coût) supérieur à 100×, avec le pari qu'une intelligence moins chère créera beaucoup plus de demande.
Concevoir un flux en huit étapes
Décomposez les questions. Posez les questions les plus explicites, étroites, spécifiques et atomiques possibles. Une question large cache plusieurs jugements derrière une réponse ; des questions atomiques les exposent, pour qu'on puisse les inspecter, les régler et les combiner dans le code. Et la décomposition ne coûte pas d'allers-retours : les questions sur un même state s'exécutent en parallèle.
L'exemple complet : trier un ticket
Le flux triage_ticket.py de la page garde le déterminisme dans le code (un ticket fermé sort tout de suite, sans modèle), n'envoie que le contexte structuré utile (message, expéditeur, liens, plan du client, commandes ouvertes, liste des identifiants sensibles), pose sept questions atomiques dans une seule requête (un Choice de sujet, cinq Nouls, un Score de frustration), puis compose les réponses avec des portes de confiance explicites. Le module suivant isole la partie « risque de spam » : trois Nouls pondérés dans le code.
    with TypeSafeClient() as client:
        response = client.system_one(
            state=state,
            questions=questions,
        )

    # Compose independent spam signals with weights controlled by code.
    answers = response.answers
    spam_risk = (
        0.45 * answers["requests_credentials"].noul
        + 0.30 * answers["sender_identity_mismatch"].noul
        + 0.25 * answers["unexpected_reward"].noul
    )

    # Escalate uncertain judgments instead of guessing.
    spam_is_uncertain = 0.4 < spam_risk < 0.6
    if spam_is_uncertain or answers["topic"].confidence < 0.75:
        return route_to_human_review(ticket)
    if spam_risk >= 0.6:
        return quarantine_as_spam(ticket)

    # Let code decide which speculative answers matter on this path.
    if answers["topic"].choice == "billing":
        return route_to_billing(
            ticket,
            refund_requested=answers["refund_requested"].noul >= 0.7,
        )
    if answers["topic"].choice == "orders":
        return route_to_orders(
            ticket,
            mentions_open_order=answers["mentions_open_order"].noul >= 0.7,
        )

    priority = (
        "high"
        if answers["frustration"].confidence >= 0.7
        and answers["frustration"].score >= 1.5
        else "normal"
    )
    return route_to_account_support(ticket, priority=priority)
Deux détails du même fichier méritent l'attention. Les questions y sont toutes structurées : chaque Noul a un objet instructions avec question, compare ou inspect, et focus, et des criteria dont true et false sont des objets avec what, not_for, examples. Et les chemins vers le state y sont cités entre accents graves (`ticket.message`, `policy.sensitive_credentials`), comme au chapitre 4.
Les quatre patterns d'architecture
TypeSafe est conçu pour vivre à l'intérieur d'un système plus grand. Penser en décisions atomiques qui se composent en comportement complexe est, dit la documentation, la compétence clé. Quatre patterns nommés la résument.
| Pattern | Ce qu'il fait | Bénéfices (doc) |
|---|---|---|
| Speculative fan-out | Envoyer beaucoup de questions en un appel, y compris spéculatives, et laisser le code décider de ce qui compte | Coût, vitesse |
| Confidence-gated routing | Utiliser la confiance comme second axe de décision pour construire des systèmes plus sûrs | Fiabilité, sécurité |
| Composite scoring | Combiner plusieurs dimensions d'analyse en un seul score | Coût, fiabilité, vitesse |
| Intent routing | Classer l'intention d'un utilisateur et router vers le bon gestionnaire | Coût, vitesse |
1 · Speculative fan-out
Parce qu'une requête accepte beaucoup de questions, la doc recommande d'y mettre toutes celles dont le système pourrait avoir besoin, puis de trier dans le code. Toutes sont évaluées en parallèle, donc en ajouter change peu le temps de réponse. L'exemple : trier un ticket de support. Au lieu de demander la catégorie, puis la gravité dans un second appel si c'est un bug, on demande les deux à la fois ; si ce n'est pas un bug, on ignore la gravité.
category = response.answers["category"]
bug_severity = response.answers["bug_severity"]
bug_repro = response.answers["has_reproducible_steps"]
refund = response.answers["refund_requested"]
frustration = response.answers["frustration"]

if category.choice == "bug_report":
    if bug_severity.score > 1.5 and bug_repro.noul > 0.6:
        escalate_to_engineering(ticket_id, severity="high")
    else:
        add_to_bug_backlog(ticket_id)

elif category.choice == "billing":
    if refund.noul > 0.7:
        route_to_billing_with_flag(ticket_id, refund_likely=True)
    else:
        route_to_billing(ticket_id)

elif category.choice == "feature_request":
    log_feature_request(ticket_id)

# Frustration is useful regardless of category
if frustration.score > 1.5:
    flag_for_priority_response(ticket_id)
Tout ce qu'il faut pour l'arbre de décision complet vient d'un seul appel. Les questions spéculatives sont ignorées quand elles ne servent pas, et économisent un aller-retour quand elles servent. La page Primitives renvoie au cookbook Parallel questions : treize questions en un appel contre treize appels, environ dix fois moins cher et dix fois plus rapide, sans changement des réponses (les deux pages donnent des multiplicateurs légèrement différents, 11,5×/9,6× et 12,2×/10,0×, sans doute deux exécutions).
2 · Confidence-gated routing
C'est le chapitre 10 : la réponse dit quoi, la confiance dit s'il faut agir, et chaque action a son seuil. Rien à ajouter ici, sinon la place de ce pattern dans la liste : c'est celui qui apporte fiabilité et sécurité, pas coût ou vitesse.
3 · Composite scoring
On veut souvent classer des éléments selon plusieurs critères à la fois. Le pattern : découper le jugement en dimensions indépendantes, noter chacune séparément (un Score par dimension, dans une seule requête), normaliser entre 0 et 1, puis combiner avec des poids que le code contrôle. L'exemple de la page : des CV d'ingénieurs notés sur quatre dimensions (profondeur Python, leadership, conception de systèmes, polyvalence), avec deux jeux de poids selon le poste.
py      = response.answers["python_depth"].score / 4
lead    = response.answers["team_leadership"].score / 4
arch    = response.answers["system_design"].score / 4
general = response.answers["generalist"].score / 4

# Senior IC
ic_score = (0.40 * py) + (0.10 * lead) + (0.40 * arch) + (0.10 * general)

# Engineering Manager
em_score = (0.15 * py) + (0.40 * lead) + (0.20 * arch) + (0.25 * general)
Ce que la page souligne : au-delà du classement, on voit exactement comment le score final est fabriqué. Si les meilleurs classés ne correspondent pas aux attentes, on ajuste les poids, sans perdre la nuance des scores individuels.
4 · Intent routing
Toutes les demandes ne méritent pas le même gestionnaire : certaines se règlent par une requête en base, d'autres par un LLM spécialisé avec son contexte, d'autres par un humain. TypeSafe se place devant, comme classifieur rapide et bon marché qui décide quel gestionnaire invoquer, au lieu de faire passer chaque message par un LLM coûteux juste pour savoir de quoi il parle.
def route_ticket(ticket_id, response):
    intent = response.answers["intent"]
    complexity = response.answers["complexity"]

    if intent.confidence < 0.5:
        # If we don't have enough confidence to classify, route to a human agent
        return route_to_human_agent(ticket_id)

    if intent.choice == "order_status":
        handle_order_status(ticket_id)

    elif intent.choice == "product_question":
        handle_with_llm(ticket_id, PRODUCT_SPECIALIST)

    elif intent.choice == "return_exchange":
        handle_with_llm(ticket_id, RETURNS_SPECIALIST)

    elif intent.choice == "complaint":
        low_confidence = complexity.confidence < 0.5
        # A higher complexity.score leans toward the "escalation needed" end of the scale.
        if complexity.score > 1 or low_confidence:
            # Too complex for safe automation, or we're not sure about the complexity; route to a human.
            route_to_human_agent(ticket_id)
        else:
handle_with_llm(ticket_id, COMPLAINT_RESOLUTION)Les questions d'une même requête sont indépendantes ; une réponse ne devient pas le contexte d'une autre. Si un jugement ultérieur dépend d'une réponse antérieure, on fait une seconde requête dans le code. Mais la doc insiste : c'est l'exception. La dépendance n'est réelle que si le code ne peut pas construire la seconde requête sans la première réponse (il en a besoin pour aller chercher plus de données, pour décider de quoi est fait le state, ou pour choisir les options de la question suivante). Trois cookbooks le font pour de vraies raisons : Skill suggestion (classer 182 skills, puis relire les trois meilleurs en texte intégral), Structure recovery (recoller les lignes, puis classer des blocs qui n'existaient pas avant), Hierarchical classification (chaque Choice décide des options du suivant).
Démo : l'assistant domotique
La seule démo listée par la documentation est un assistant de maison connectée. Elle montre le fan-out spéculatif à son maximum, et comment TypeSafe s'associe à un LLM quand il faut quand même générer du texte.
Prenez la requête « Turn off all of the lights in the house ». Le code n'a besoin que de quatre réponses : la catégorie de la requête (commande domotique), le domaine visé (toute la maison), le type d'appareil (lumières), l'action (éteindre). La dernière question est écrite en supposant que l'utilisateur commande des lumières, et on la pose avant de savoir si c'est le cas. C'est une question spéculative : on l'évalue en parallèle avec les autres et le code filtre après coup. Chaque requête utilisateur est ainsi évaluée contre une longue liste de questions, dont beaucoup seront sans objet.
La mauvaise façon, dit la page, serait de découper en appels successifs : la catégorie d'abord ; puis, une fois sûr que c'est une commande, le domaine et l'appareil ; puis, une fois sûr que ce sont des lumières, l'action. Cela minimise le nombre de questions, mais c'est bien plus lent et plus cher qu'un seul appel groupé.
TypeSafe + LLM
La démo montre aussi deux façons d'associer Jev à un modèle génératif, pour un système qui a parfois besoin d'une étape de génération de texte :
- Découper une requête composée. Un Noul demande si la requête réclame plus d'une action distincte. Si oui, un LLM découpe la phrase en une liste de commandes atomiques, que TypeSafe évalue ensuite une par une.
- Basculer sur un LLM conversationnel. Quand TypeSafe détermine que la requête est une demande d'information générale ou de conversation, le système appelle un LLM pour générer une réponse libre. Les comportements déterministes connus sont traités vite et à bas coût ; la souplesse d'un LLM reste disponible quand il le faut. La réponse initiale de TypeSafe est si rapide comparée à celle du LLM qu'elle ajoute une latence négligeable.
La page indique que la démo est une application Vite/React dont le code source complet « sera disponible sur GitHub à la sortie » ; à la date de lecture, seul un enregistrement vidéo est proposé. Le cours ne décrit donc pas son code.
Où placer Jev : la carte des cas d'usage
La page Example use cases est faite pour brainstormer : ouvrir le secteur le plus proche, parcourir les décisions d'exemple, les adapter à ses propres documents et actions. Elle commence par cinq grandes familles.
Entrelacer l'IA avec du logiciel fiable, de façon à pouvoir l'exécuter un million de fois en arrière-plan sans copilote humain. Le code possède le flux de contrôle, TypeSafe les décisions sémantiques.
Une intelligence de pointe à vitesse temps réel (la page dit 150 ms) : assez rapide et assez intelligente pour être programmée dans un jeu ou intégrée à une interface.
Cent fois moins cher, donc capable de traiter des jeux de données géants : chercher dans d'immenses corpus, classer des traces d'agents, extraire des caractéristiques.
Vérifier le prompt, les extractions, les traces de raisonnement, les appels d'outils de n'importe quelle autre IA : jailbreaks, erreurs de citation, hallucinations, à une fraction du coût de l'appel LLM.
Rendre le harnais d'un agent plus malin : routage de modèles, récupération de contexte sémantique, détection d'erreurs et garde-fous, classification de traces de raisonnement.
Par secteur
Dix-neuf accordéons dans la page. Chacun liste des décisions typiques ; en voici le contenu, condensé mais fidèle.
Recherche et récupération
- Remplacer ou compléter les embeddings d'un pipeline RAG par de la recherche, du scoring et du classement sémantiques.
- Noter la pertinence requête → candidat ; reclasser par comparaisons ; cross-encoder pour plus de précision.
- Sélectionner le contexte utile pour les flux d'IA en aval.
Découverte scientifique
- Filtrer des articles selon des critères d'inclusion et d'exclusion pour une revue systématique.
- Étiqueter des passages de transcriptions, de réponses ouvertes, de notes de terrain.
- Vérifier qu'un passage cité soutient une affirmation ; repérer les détails méthodologiques manquants ; relier des entités entre articles.
Routage de modèles
- Construire un routeur qui choisit quel LLM reçoit chaque prompt ; classer intention et domaine ; estimer difficulté et risque ; escalader vers un modèle plus cher quand il le faut.
Garde-fous LLM
- Placer des vérifications sémantiques sur chaque entrée, sortie et appel d'outil d'un LLM, à une fraction du coût de l'appel.
- Détecter jailbreaks et injections de prompt, violations de politique, exposition de données sensibles, erreurs d'appels d'outils ; journaliser des résultats structurés et des probabilités.
Lint sémantique de code
- Ajouter des lints sémantiques automatisés au code et aux textes, selon les conventions de l'équipe, exécutés en CI.
Extraction de caractéristiques pour la prédiction
- Extraire des caractéristiques probabilistes de textes, les combiner à des données structurées, entraîner des modèles sur des résultats connus ; des boucles autoresearch proposent et évaluent les définitions de caractéristiques.
Recrutement
- Évaluer CV, candidatures et retours d'entretien contre des critères explicites liés au poste ; identifier l'expérience pertinente ; noter les compétences ; router et escalader les cas incertains.
Génération de leads
- Comparer profils d'entreprise, biographies de dirigeants et messages entrants à un profil client idéal ; noter l'adéquation ; détecter intention d'achat et points de douleur ; prioriser.
Support client
- Classer les tickets par problème, produit, intention ; extraire problèmes et engagements des transcriptions d'appels ; détecter urgence, frustration, risque de départ, demandes de remboursement ; router ; vérifier les réponses contre les politiques.
Sinistres d'assurance
- Classer déclarations, notes d'experts et pièces ; détecter complexité, informations manquantes, indices de fraude ; prioriser pour traitement direct ou revue spécialisée.
Criminalité financière
- Évaluer récits de transactions, documents KYC, historiques d'alertes ; rapprocher des entités aux noms incohérents ; prioriser les alertes ; router les cas ambigus.
Juridique et conformité
- Classer contrats, politiques, dépôts réglementaires, allégations marketing ; détecter clauses manquantes et allégations interdites ; escalader vers les juristes.
Places de marché e-commerce
- Normaliser des fiches produit hétérogènes ; extraire des attributs ; détecter contrefaçons, abus d'avis, violations de politique ; classer et router pour revue humaine.
Modération, confiance et sécurité
- Appliquer des critères propres à l'entreprise ; détecter toxicité, harcèlement, spam, fraude, conseils dangereux, données personnelles, demandes de désinscription ; combiner gravité et confiance pour autoriser, avertir, revoir ou bloquer.
Publicité
- Évaluer créations, textes de campagne, pages d'atterrissage et contexte de placement ; classer sécurité de marque et adéquation d'audience ; vérifier la conformité et l'alignement annonce / page.
Jeu vidéo
- Évaluer signalements, chat en jeu, avis et conversations de support ; modérer ; annoter frustration et engagement ; détecter les signaux de départ.
Évaluation des risques
- Convertir rapports d'incidents, notes de sinistres, descriptions de transactions et évaluations de fournisseurs en indicateurs probabilistes ; classer les types de risque ; noter la gravité ; alimenter des modèles plus larges.
Prévision de la demande
- Enrichir les modèles de prévision de signaux sémantiques tirés des demandes clients, notes de vente, avis, tickets et rapports de marché ; extraire intention, urgence, intérêt produit ; détecter tensions d'approvisionnement et pression concurrentielle.
Graphes de connaissances
- Annoter et vérifier des graphes avec des décisions sémantiques typées ; classer relations et types d'entités ; détecter les contradictions ; parcours probabiliste et classification hiérarchique.
Par forme de décision
| Forme | Quand y recourir | Exemples |
|---|---|---|
| Classification | Une catégorie connue doit l'emporter | Intention, sujet, service, type de risque, type d'entité |
| Détection | Il faut la probabilité qu'une propriété soit présente | Spam, fraude, urgence, jailbreaks, données sensibles |
| Scoring | La réponse appartient à une grille ordonnée | Gravité, pertinence, qualité, frustration, adéquation |
| Routage | Une catégorie choisit le chemin de code suivant | Usage d'outils, escalade, routage de modèles, files de support |
| Recherche | Trouver les éléments qui répondent à une requête en langage naturel | Recherche sémantique, découverte de documents, génération de candidats |
| Récupération | Un flux a besoin du contexte ou des enregistrements les plus pertinents | Contexte RAG, preuves, consultation de connaissances |
| Classement | Ordonner par pertinence ou qualité sémantique | Résultats de recherche, recommandations, priorisation de candidats |
| Vérification | Contrôler un artefact contre des modes d'échec précis | Support des citations, violations de politique, erreurs d'appels d'outils |
| Extraction de caractéristiques ML | Un modèle ML classique a besoin de signaux sémantiques | Intention d'achat, intérêt produit, pression concurrentielle, départ |
| Extraction de données structurées | Des champs connus doivent être récupérés d'une entrée non structurée | Attributs de candidats, champs de commande, étiquettes de documents |
Pratique : l'API HTTP
Un point d'entrée, un corps JSON, des codes d'erreur standards. Voici la référence condensée, telle que la page API reference la donne.
Le point d'entrée
POST https://api.typesafe.ai/v1/systemone
Authorization: Bearer <API_KEY>
Content-Type: application/json
La clé d'API se crée dans la console (console.typesafe.ai/keys). Le corps a les trois champs vus au chapitre 3, tous requis : state (string | object | array), model (string) et questions (map<string, Question>). Une Question est l'un des trois types ; tous partagent type et instructions, chacun a ses criteria.
| Type | instructions | criteria | Contraintes |
|---|---|---|---|
| noul | requis, string | object | array | optionnel : objet {true, false} | — |
| choice | requis | requis : map<option, string | object | array | null> | au plus 255 options |
| score | requis | requis : array<string | object | array>, ordonné du bas vers le haut | au moins 2 niveaux, au plus 10 |
{
  "state": "Help! My payouts have been failing for 3 days.",
  "model": "jev-latest",
  "questions": {
    "is_urgent": {
      "type": "noul",
      "instructions": "Does this convey urgency?",
      "criteria": {
        "true": "Explicitly time-sensitive",
        "false": "No urgency expressed"
      }
    }
  }
}
{
"state": "Help! My payouts have been failing for 3 days.",
"model": "jev-latest",
"questions": {
"department": {
"type": "choice",
"instructions": "Which team should handle this?",
"criteria": {
"billing": "Payments, invoicing, refunds",
"technical": "Bugs, outages, integrations",
"sales": "Pricing, upgrades, new accounts"
}
}
}
}{
"state": "Help! My payouts have been failing for 3 days.",
"model": "jev-latest",
"questions": {
"frustration": {
"type": "score",
"instructions": "How frustrated is the customer?",
"criteria": ["Calm", "Frustrated", "Very angry"]
}
}
}{
"model": "jev-1.13.0",
"answers": {
"is_urgent": { "type": "noul", "noul": 0.95 }
},
"usage": { "input_tokens": 307, "output_tokens": 20 }
}{
"model": "jev-1.13.0",
"answers": {
"department": {
"type": "choice",
"choice": "billing",
"probabilities": { "billing": 0.88, "technical": 0.12, "sales": 0.0 },
"confidence": 0.81
}
},
"usage": { "input_tokens": 318, "output_tokens": 34 }
}{
"model": "jev-1.13.0",
"answers": {
"frustration": {
"type": "score",
"score": 1.05,
"legend": { "0": "Calm", "1": "Frustrated", "2": "Very angry" },
"probabilities": { "0": 0.0, "1": 0.95, "2": 0.05 },
"confidence": 0.92
}
},
"usage": { "input_tokens": 304, "output_tokens": 18 }
}Erreurs et limites de débit
| Statut | Signification |
|---|---|
401 Unauthorized | Clé d'API absente ou invalide. Vérifiez l'en-tête Authorization. |
422 Unprocessable Entity | Le corps a échoué à la validation : champ requis manquant, question mal formée. Le corps de la réponse désigne le champ fautif. |
429 Too Many Requests | Limite de débit dépassée. Attendre puis réessayer. |
529 Overloaded | TypeSafe est temporairement surchargé. Réessayer après un court délai. |
Sur 429 et 529, la consigne est de réessayer avec un backoff exponentiel, pas immédiatement. Les SDK le font par défaut et respectent l'en-tête retry-after quand il est présent. Un dernier point d'API : GET /v1/models renvoie la liste des noms que votre compte peut envoyer dans model, avec description et date de sortie ; il liste actuellement les alias, mais les identifiants versionnés comme jev-1.13.0 sont acceptés qu'ils apparaissent ou non.
422. Que regarder en premier ?Pratique : les SDK Python et JavaScript
Deux clients officiels, tous deux très récents à la date de lecture : Python typesafe-sdk (première version publique v0.5.7 le 14 septembre 2026, v0.7.0 le 18) et JavaScript @typesafe-ai/sdk (v0.5.7 le 11 septembre, v0.6.0 le 15).
- Installer, configurer par variables d'environnement, appeler
system_one/systemOne. - Python : clients sync et async, réponses typées par
response_model, retries, journalisation, compatibilité ascendante. - JavaScript : helpers
choice(),score(),noul(), inférence des types de réponse, politique de retry.
Python
Requiert Python 3.10 ou plus. Le client lit TYPESAFE_API_KEY dans l'environnement et appelle jev-latest par défaut. Deux clients : TypeSafeClient (synchrone) et AsyncTypeSafeClient. La réponse expose answers (toutes les réponses, par identifiant) et trois vues typées, nouls, choices, scores.
pip install typesafe-sdk
# ou
uv add typesafe-sdk
export TYPESAFE_API_KEY="..."
from typesafe_sdk import Choice, Noul, Score, TypeSafeClient
with TypeSafeClient() as client:
response = client.system_one(
state={"document": "I was charged twice. Please fix this ASAP."},
questions={
"billing": Noul(instructions="Is this ticket about billing?"),
"tone": Choice(
instructions="What is the customer's tone?",
criteria={"calm": None, "frustrated": None, "angry": None},
),
"urgency": Score(
instructions="How urgent is this ticket?",
criteria=["can wait", "this week", "today"],
),
},
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)from typesafe_sdk import AsyncTypeSafeClient, Choice, Noul, Score
async def main() -> None:
async with AsyncTypeSafeClient() as client:
response = await client.system_one(
state={"document": "I was charged twice. Please fix this ASAP."},
questions={
"billing": Noul(instructions="Is this ticket about billing?"),
"tone": Choice(
instructions="What is the customer's tone?",
criteria={"calm": None, "frustrated": None, "angry": None},
),
"urgency": Score(
instructions="How urgent is this ticket?",
criteria=["can wait", "this week", "today"],
),
},
)
print(response.nouls["billing"].noul)
print(response.choices["tone"].choice)
print(response.scores["urgency"].score)Réponses typées avec response_model
Depuis la v0.7.0 (qui a remplacé msgspec par pydantic), system_one accepte un response_model : une sous-classe de SystemOneResponse qui déclare les réponses attendues, ou même un modèle pydantic entièrement à vous. Le résultat expose alors chaque réponse comme un attribut typé, et l'identifiant de requête via request_id.
from typesafe_sdk import Noul, NoulAnswer, SystemOneResponse, TypeSafeClient

class BillingResponse(SystemOneResponse):
    billing: NoulAnswer

with TypeSafeClient() as client:
    result = client.system_one(
        "I was charged twice.",
        {"billing": Noul(instructions="Is this about billing?")},
        response_model=BillingResponse,
    )
    assert 0 <= result.billing.noul <= 1
    assert result.billing == result.nouls["billing"]
    print(result.request_id)
Retries, erreurs, journalisation, environnement
Une RetryPolicy se passe au client ou par appel (RetryPolicy(max_retries=3, backoff_max=0.2, timeout=1.0) dans l'exemple). Les erreurs de l'API lèvent TypeSafeAPIError, avec status et request_id. Le SDK journalise sur le logger typesafe_sdk ; TYPESAFE_LOG_LEVEL accepte debug, info, warning, error ou off. En debug, les en-têtes et corps sont journalisés ; les en-têtes secrets sont masqués, les corps ne le sont pas.
| Variable | Configure | Défaut |
|---|---|---|
TYPESAFE_API_KEY | Clé d'API (requise) | — |
TYPESAFE_BASE_URL | Racine de l'API | https://api.typesafe.ai |
TYPESAFE_DEFAULT_MODEL | Modèle par défaut | jev-latest |
TYPESAFE_LOG_LEVEL | Niveau du logger, appliqué à l'import | non défini (Python) · warn (JS) |
Compatibilité ascendante
Le SDK continue de fonctionner quand l'API évolue : extra_body envoie des champs de requête que la version du SDK ne connaît pas encore ; des dictionnaires de questions bruts passent tels quels ; les genres de réponse inconnus sont ignorés avec un avertissement, et raw_http_response donne accès au JSON complet. La doc précise que ce sont des issues de secours et qu'il vaut mieux mettre à jour le SDK.
JavaScript / TypeScript
Requiert Node.js 20 ou plus. Le paquet fournit ESM, CommonJS et déclarations TypeScript. Trois helpers construisent les questions, choice(instructions, criteria), score(instructions, criteria) et noul(instructions?, criteria?), et les types des réponses sont inférés des questions : answers.department.choice est typé comme l'une des clés de vos options.
npm install @typesafe-ai/sdk
export TYPESAFE_API_KEY="..."
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";
const client = new TypeSafeClient();
const response = await client.systemOne({
state: { document: "I was charged twice. Please fix this ASAP." },
questions: {
category: choice("What is this ticket about?", {
billing: null,
technical: null,
other: null,
}),
},
});
console.log(response.answers.category.choice);// Dérivé de la référence du SDK JS : les trois helpers dans une requête.
import { choice, noul, score, TypeSafeClient } from "@typesafe-ai/sdk";
const client = new TypeSafeClient({ timeout: 10000, retry: { maxRetries: 2 } });
const { answers, model, usage } = await client.systemOne({
state: "I was charged twice. Please help ASAP.",
questions: {
billing: noul("Is this about billing?"),
tone: choice("What is the tone?", { calm: null, angry: null }),
urgency: score("How urgent is this?", ["low", "medium", "high"]),
},
});
console.log(answers.billing.noul, answers.tone.choice, answers.urgency.score);
console.log(model, usage.input_tokens);Le constructeur TypeSafeClient(config) accepte apiKey, baseURL, defaultModel, timeout (par tentative, 10 000 ms par défaut), retry, logLevel, logger, defaultHeaders, fetch, et dangerouslyAllowBrowser (faux par défaut : utiliser le SDK dans un navigateur expose la clé aux visiteurs). Les options explicites priment sur les variables d'environnement, elles-mêmes sur les défauts du SDK. La politique de retry par défaut : 2 tentatives supplémentaires, backoff initial 500 ms doublé jusqu'à 5 000 ms avec 25 % de gigue, sur les statuts 408, 429 et 500–599, en honorant Retry-After jusqu'à 60 s. Les erreurs sont des classes dédiées (AuthenticationError, RateLimitError, UnprocessableEntityError, APITimeoutError…), toutes dérivées de TypeSafeError.
Dans les deux SDK, les versions 0.6.0 (15 septembre 2026) ont changé Score.criteria : un tableau ordonné de descriptions, au lieu d'un dictionnaire indexé par entiers. Les exemples de ce cours utilisent la forme actuelle. Si vous tombez sur du code avec {0: "...", 1: "..."}, il date d'avant.
dangerouslyAllowBrowser ?Modèles, prix et limites
Un seul modèle courant, deux alias, un prix par token d'entrée, des limites de contexte et de débit. Tout tient dans un tableau, tiré de la page Models.
| Jev 1.13 | jev-1.13.0 |
|---|---|
| Prix (par Btok / par Mtok) | 42 $ / 0,042 $, facturé sur les tokens d'entrée ; les tokens de sortie sont gratuits |
| Limites de débit | 250 000 tokens par seconde / 1 200 requêtes par minute ; au-delà, 429 |
| Longueur de contexte | 64k tokens par requête ; 32k tokens pour le state plus la question la plus longue |
| Entrée | Texte seulement : chaîne, objet JSON ou tableau de textes. Ni image, ni audio, ni vidéo |
La page prévient que les limites de débit changent sans préavis pendant que TypeSafe absorbe une forte demande et laisse entrer plus d'utilisateurs ; des limites plus stables viendront « une fois les choses calmées ». Des limites plus hautes existent sur plans personnalisés et entreprise.
Alias
Un alias est un nom qui résout vers un identifiant versionné. jev-latest pointe vers jev-1.13.0 : la version stable la plus récente, le défaut des SDK et le nom utilisé dans les exemples. jev-preview pointe vers la version la plus récente, officielle ou non ; il passe devant jev-latest quand une préversion existe. À la date de lecture, les deux pointent sur le même modèle : il n'y a pas de préversion disponible.
Conséquence pratique soulignée par la page : un alias bouge à chaque sortie, donc les réponses derrière peuvent changer sans rien changer chez vous. Le champ model de la réponse donne l'identifiant versionné qui a répondu, à journaliser. Et si vous avez réglé des seuils de confiance sur une version précise, épinglez son identifiant plutôt que l'alias, et migrez à votre rythme.
Personnaliser Jev
Jev n'est ni fine-tuné ni adapté par LoRA avec des données client ; les mêmes poids servent tous les comptes. On façonne ses réponses par la requête : contenu propriétaire, enregistrements et références dans le state ; règles métier et cas limites dans instructions et criteria ; jugements larges décomposés en questions atomiques combinées dans le code ; et, pour aller plus loin, un modèle classique entraîné sur les probabilités de Jev (cookbook AutoResearch).
Langues et données
L'anglais est la langue principale d'entraînement, celle où la précision est la meilleure. Les autres langues, y compris les écritures CJK, sont traitées mais moins bien : testez sur votre contenu avant de vous y fier, et surveillez la confiance de près pour le routage. Jev n'est pas entraîné sur les requêtes et réponses des clients ; la page Legal renvoie à l'accord de traitement des données, à la politique de confidentialité, et propose la rétention zéro (ZDR) aux clients entreprise.
model envoyer ?Faire écrire l'intégration par un agent : le skill TypeSafe
TypeSafe publie un skill pour Claude Code, Codex et les autres agents de code : les trois types de questions, les patterns et les bonnes pratiques, pour que l'agent connaisse les formes de requête et de réponse au lieu de les inventer.
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai

# mise à jour
claude plugin marketplace update typesafe-ai
claude plugin update typesafe@typesafe-ai
npx skills add typesafe-ai/skills --skill typesafe-ai
# -g pour une installation globale ; npx skills update pour mettre à jourChoisissez une seule méthode d'installation pour éviter les doublons. Le fichier SKILL.md est lisible sur GitHub (typesafe-ai/skills). Dans un prompt, nommer le skill (« use the TypeSafe skill ») marche avec tout agent ; avec le plugin Claude Code, on peut aussi invoquer /typesafe:typesafe-ai.
Trois prompts suggérés
- Explorer : « Using the TypeSafe skill, explore the project and find opportunities for using intelligent judgement to stand in for complex parsing or other fragile code. »
- Expérimenter avec une clé exportée dans
TYPESAFE_API_KEY: « run some experiments… Propose changes based on the most promising results. » - Refactorer à partir des cookbooks : « analyze my code and see if there are any applicable cookbooks… »
Principes de « vibe coding » selon la page
- Discuter avec l'agent, à partir des prompts ci-dessus.
- Relire le plan avant de l'implémenter.
- Mettre les constantes (questions et seuils) à un seul endroit, faciles à relire : les agents ne sont pas très bons pour écrire des questions, attendez-vous à les éditer avec eux.
- Ne pas prendre les affirmations pour argent comptant ; pousser l'agent à valider ses hypothèses.
Problèmes courants
- L'agent n'utilise pas le skill : l'invoquer explicitement, vérifier que l'installation ciblait bien cet agent, redémarrer.
- Le routage ne se comporte pas comme prévu : vérifier questions et seuils. Trop haut, des faux négatifs ; trop bas, des faux positifs.
- Des seuils de confiance partout : si l'on veut seulement la meilleure option, prendre celle de plus haute probabilité, sans seuil ; pour un algorithme statistique précis, utiliser les probabilités.
- Le code TypeSafe est dur à relire : ce que les humains doivent relire, ce sont les questions et les constantes de seuil ; les regrouper dans un seul fichier.
- L'agent invente des champs de requête ou de réponse : un skill périmé ; mettre à jour et réessayer.
La page Primitives ajoute une raison de plus d'installer le skill : les agents de code tombent plus que les humains dans l'habitude « une question par appel ». Le skill leur dit de grouper beaucoup de questions par appel, y compris celles qui ne comptent que pour certaines entrées.
Les cookbooks : dix-huit applications complètes
Les cookbooks sont des notebooks exécutés, avec leurs chiffres. Ils montrent Jev dans des pipelines réels : extraction, classification, reclassement, vérification, garde-fous, auto-cohérence. Voici la carte, filtrable par primitive et par technique, avec le résultat annoncé par chacun.
Ce que les cookbooks enseignent, en cinq idées
- Trouver, puis choisir. Jev ne génère pas : quand la réponse est une valeur du texte, un regex ou un autre modèle trouve les candidats et un Choice choisit (Pre-parsed value extraction, Date extraction, Function calling). La valeur retournée est copiée telle quelle, jamais inventée.
- Une requête par document, autant de questions qu'il faut. Parallel questions mesure le gain du groupement : environ dix fois moins cher et plus rapide sur un document de 54 000 caractères, avec les mêmes réponses.
- La confiance sépare les cas faciles des cas durs. Classification using confidence classe 60 rapports annuels en 75 groupes industriels : au seuil 0,9, la moitié confiante est juste à 90 %, l'autre à 40 % ; remontée d'un cran dans la hiérarchie, cette moitié passe à 70 %, sans second appel.
- Vérifier, moins cher que produire. SDE cascade extrait avec un petit modèle, vérifie chaque champ avec des Nouls TypeSafe, et n'escalade vers le gros modèle de raisonnement que si un signal s'allume. Citation check et Guardrails appliquent la même idée aux citations et aux messages d'un LLM.
- Des réponses stables. Les deux cookbooks Self-consistency rejouent quinze fois le même rubric et comparent la dispersion des réponses de Jev à celles de LLM, y compris à température 0.
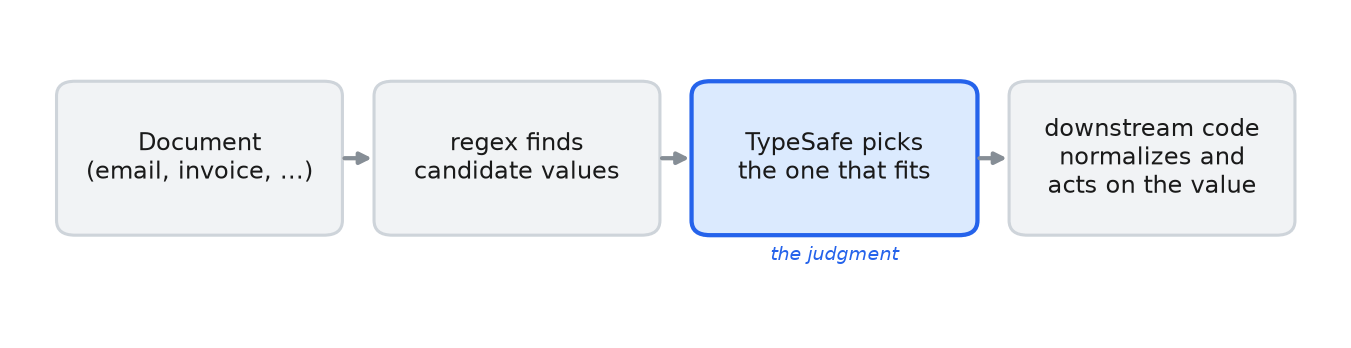
/cookbooks/pre_parsed_value_extraction_cookbook) : le regex trouve les valeurs candidates, TypeSafe en choisit une, le code la normalise et agit.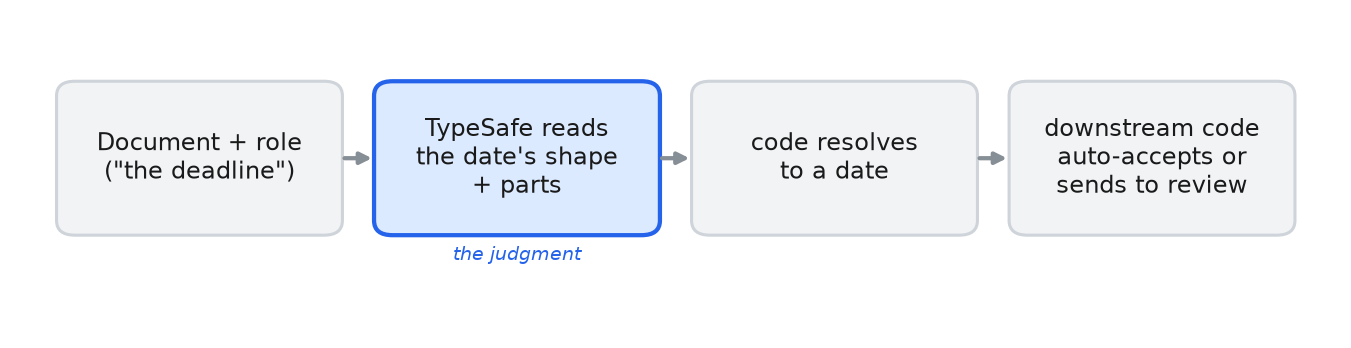
/cookbooks/date_extraction_cookbook) : TypeSafe lit comment la date est écrite et quelles parties le texte nomme ; le code assemble la date, compte à partir d'aujourd'hui si elle est relative, et l'accepte ou l'envoie en relecture.
/cookbooks/sde_cascade) : le compromis qualité / coût sur 100 prompts entre le petit modèle, le modèle de raisonnement, et la cascade vérifiée par TypeSafe.
/cookbooks/rerank_typesafe) : recherche rapide (BM25) pour la liste courte, puis reclassement par une question TypeSafe par paire requête-candidat.Plusieurs cookbooks (Classification using confidence, Line-by-line search, entre autres) livrent un cache JSON de leurs appels d'API (json_cache.json, ou la classe JsonCache du paquet cooksafe), de sorte que le notebook se rejoue sans clé ni dépense. Supprimer le cache relance tout en direct. L'installation type : pip install "typesafe-sdk>=0.5.7" cooksafe --extra-index-url https://pypi.typesafe.ai/.
Les limites connues : la « jaggedness » de Jev 1.13
La documentation tient une page honnête de ce que jev-1.13 fait mal, revue le 17 septembre 2026. Rapide, calibré, bon en jugement de bon sens ; mais littéral, mauvais en calcul, fragile face à l'indirection. Neuf modes d'échec, et pour chacun quoi faire à la place.
| # | Mode d'échec | Faire plutôt |
|---|---|---|
| 1 | Lecture littérale | Écrire la condition exacte, des critères pour chaque option |
| 2 | Mathématiques et nombres | Garder l'arithmétique dans le code |
| 3 | Comparaison de dates et d'heures | Extraire les composants ; comparer dans le code |
| 4 | Indirection | Réduire les sauts ; pointer le state pertinent |
| 5 | Grand state plein de détails inutiles | Filtrer d'abord ; n'envoyer que ce dont la question a besoin |
| 6 | Contenu adversarial | Écrire des prompts précis, tester les cas limites avant de déployer |
| 7 | Instructions et critères contradictoires | Aligner critères et instruction |
| 8 | Invariants structurels de bon sens | Poser chaque décision d'une seule façon ; imposer les identités dans le code |
| 9 | Génération | Utiliser un modèle génératif |
1 · Lecture littérale
jev-1.13 répond à la question écrite, pas à celle que vous vouliez dire. Mots de portée, négations, conditions implicites sont lus au pied de la lettre, là où une personne aurait lu l'intention.
À la place : écrire la condition exacte dans instructions, mettre les cas limites dans les critères. Quand, devant une mauvaise réponse, vous vous surprenez à expliquer « ce que je voulais vraiment dire », cette explication est la moitié manquante de l'instruction. Si l'interprétation est inévitable, la découper en deux questions littérales combinées dans le code.
2 · Mathématiques et nombres
Jev n'est pas une calculatrice. Trois cas documentés :
- Compter : caractères d'un mot, occurrences d'un terme, éléments d'une longue liste. Le modèle reconnaît la forme d'une réponse plutôt qu'il ne compte, et l'erreur grandit avec la taille. À la place : itérer dans le code sur les candidats, poser un Noul par élément, additionner soi-même (exemple de la page : «
items[i]est-il un nom de fruit ? » pour chaque élément). - Représentations numériques : des couleurs en hexadécimal marchent moins bien que des noms de couleurs ; Jev ne sait pas juger si deux triplets RGB sont proches ; l'assembleur ou le binaire moins bien qu'un langage de haut niveau. À la place : convertir dans le code, passer un nombre calculé ou une catégorie nommée, garder le modèle pour le jugement (« cette couleur se lit-elle comme un avertissement ? »).
- Calcul à partir du score : ne pas utiliser un score pour reconstituer la grandeur exacte entre deux niveaux ; un seuil, oui, une interpolation, non.
3 · Comparaison de dates et d'heures
Jev lit les dates comme du texte, pas comme des quantités ordonnées : laquelle vient d'abord, quel écart, dans quelle fenêtre. Pire avec les formats mélangés, les références relatives et les bornes de domaine (trimestres, fenêtres de règlement).
À la place : séparer. L'extraction est un jugement, le modèle s'en charge ; l'arithmétique reste dans le code. Chaque partie d'une date est un petit ensemble fermé (douze mois, trente et un jours, une plage d'années) : l'extraction devient un Choice sur des options énumérées, avec une option explicite « non indiqué ». Le cookbook Date extraction fait la version complète.
4 · Indirection
Doubles négations, indirection complexe, question sur la propriété d'une propriété, plusieurs sauts de raisonnement : autant de précision perdue. À la place : des instructions aussi directes que possible, et nommer les parties du state concernées.
5 · Grand state plein de détails inutiles
La précision baisse quand le state grossit avec du contenu sans rapport avec la décision : le détail inutile distrait, et un grand state rend difficile de savoir quelle partie a produit une mauvaise réponse. À la place : récupérer et filtrer dans le code, n'envoyer que les champs nécessaires ; quand on ne peut pas filtrer, un Noul de pertinence peut le faire (cookbook Classifying RAG passages). Rappel des limites : 64k tokens par requête, 32k pour le state plus la plus longue question.
6 · Contenu adversarial
Le state est de la donnée, et Jev ne le traite pas comme hostile par défaut. Un contenu écrit pour orienter le modèle (instruction injectée, cadrage trompeur, texte qui plaide pour sa propre classification) peut déplacer la réponse. TypeSafe dit s'attendre à s'améliorer sur ce point. À la place : des critères explicites, et des tests approfondis avant d'exposer l'intégration à beaucoup d'utilisateurs.
7 · Instructions et critères contradictoires
Quand instructions et criteria demandent des choses différentes, le modèle peut se perdre. Un Noul où true correspond à « non » et false à « oui » marchera moins bien. À la place : traiter les critères comme un prolongement de l'instruction, avec un langage que la personne moyenne lit sans effort.
8 · Invariants structurels de bon sens
jev-1.13 est très constant : des entrées sémantiquement proches donnent des sorties quantitativement proches. Mais beaucoup d'invariants qu'on imaginerait tenir ne sont pas garantis. Deux mesures de la page :
| « Is the customer asking for a refund? » sur « I'm not happy with the fit. What are my options here? » | Noul noul | Choice yes | Choice no | Choice confidence |
|---|---|---|---|---|
| Même question, deux types | 0,22 | 0,01 | 0,99 | 0,97 |
| Sur « I was charged twice for the same order. Can someone look into this? » | refund | not_refund | Somme |
|---|---|---|---|
| Une question et sa négation, deux Nouls | 0,72 | 0,47 | 1,19 |
À la place : ne pas compter sur une invariance attendue ; formuler les questions pour qu'elles disent directement ce qu'on veut ; ne pas transposer un seuil réglé sur un Noul à un Choice ; ne pas exiger du modèle des identités arithmétiques entre questions séparées. Un Choice est relatif (il tranche laquelle), un Noul est absolu (il peut être bas pour toutes les options) ; le cookbook Skill suggestion utilise les deux sur la même liste.
9 · Génération
Jev n'est pas entraîné à générer du texte. On peut le forcer en enchaînant des Choices, mais cela marche mal et très lentement. À la place : quand l'espace de réponse est borné, transformer l'extraction en Choice sur des options plutôt que demander la valeur elle-même ; et pour vraiment générer du texte, « il y a d'autres modèles pour ça ».
- Demander au modèle quelque chose que le code peut calculer exactement.
- Cacher plusieurs jugements dans une seule question.
- Les tâches « Système 2 » : plus de couches d'indirection.
- Donner plus de contexte dans le
stateque la question n'en a besoin : Jev souffre du context rot, la matière sans rapport coûte de la précision.
Récapitulatif, glossaire et quiz final
Ce qu'il faut garder du cours, en une page. Puis cinq questions qui traversent tous les chapitres.
| System One | Une classe de modèles pour des décisions rapides et structurées, consommables par du logiciel. Jev en est le premier. Pas de texte généré ; des décisions typées et des probabilités calibrées (RLCD). |
| Requête | state (chaîne, objet ou tableau) + model + questions (map d'identifiants vers des questions typées). Un seul point d'entrée : POST /v1/systemone. |
| Choice | Une option parmi un ensemble fixe (jusqu'à 255). Renvoie choice, probabilities, confidence. Ajouter other si la liste peut ne pas tout couvrir. |
| Score | Une position sur des niveaux ordonnés (2 à 10), décrits comme des situations. Renvoie score (moyenne pondérée des numéros de niveaux), legend, probabilities, confidence. |
| Noul | La probabilité d'un oui, de 0 à 1. Pas de confiance séparée. Le seuil dépend du coût de l'erreur ; le milieu peut aller à une personne. |
| Confidence | Dérivée de la forme de probabilities (formule non publiée). Trois plages : agir, confirmer, escalader. Les seuils suivent le risque de chaque action et vivent dans le code. |
| Construire | Code quand on peut ; state décomposé et structuré ; questions atomiques, structurées si besoin ; beaucoup de questions par requête ; composition dans le code ; routage sur l'incertitude. |
| Patterns | Speculative fan-out, Confidence-gated routing, Composite scoring, Intent routing. Une seconde requête seulement quand la première réponse est nécessaire pour construire la seconde. |
| Modèle | jev-1.13.0 ; alias jev-latest et jev-preview (identiques à la date de lecture). 0,042 $ par Mtok en entrée, sortie gratuite ; 64k / 32k tokens ; texte seulement ; anglais d'abord. |
| Limites | Littéral, pas calculatrice, dates en texte, fragile à l'indirection et au bruit dans le state, sensible au contenu adversarial, pas d'invariants entre types, ne génère pas. |
Glossaire
- state : le contenu à évaluer, envoyé dans le champ
state. - question : un jugement typé demandé au modèle ; answer : la valeur typée renvoyée sous le même identifiant.
- instructions : la question posée ; criteria : les options (Choice), les niveaux (Score) ou la définition du oui et du non (Noul).
- probabilities : la distribution sur les options ou niveaux, somme 1 ; legend : les niveaux d'un Score rappelés par numéro.
- confidence : résumé de 0 à 1 de la concentration de la distribution (Choice et Score).
- question spéculative : posée d'avance, dans le même appel, avant de savoir si elle servira.
- context rot : la perte de précision quand le state contient de la matière sans rapport avec la question.
- RLCD : Reinforcement Learning for Calibrated Decisions, le post-entraînement de TypeSafe.
- calibration : sur un lot de prédictions, une probabilité annoncée de p se vérifie dans une proportion voisine de p.
- jaggedness : les « bords irréguliers », les tâches sur lesquelles le modèle est nettement moins bon que sur les autres.
probabilities {0: 0, 1: 1, 2: 0}, le second {0: 0,5, 1: 0, 2: 0,5}. Que conclure ?Pour aller plus loin
- Le Playground : coller un texte, ajouter des questions, voir les réponses. C'est le point de départ recommandé par le Quick start.
- La documentation, dont l'index llms.txt ; chaque page existe en Markdown en ajoutant
.mdà son URL. - Le manifeste de TypeSafe, et la communauté Discord où la page Jaggedness invite à signaler de nouveaux modes d'échec.
© 2026 Yann ZINENBERG. Tous droits réservés. Cours généré le 20 septembre 2026 à partir de la documentation officielle de TypeSafe AI (docs.typesafe.ai, index llms.txt, pages lues en Markdown ; dates de mise à jour des pages selon le sitemap : du 26 août au 20 septembre 2026). Les illustrations du dossier assets/origin/ viennent de la documentation ; les autres schémas ont été dessinés pour ce cours. Aucune valeur n'a été inventée : les modules interactifs reprennent des réponses enregistrées citées par la documentation, ou sont signalés comme illustrations. Rien n'est envoyé sur le réseau à l'exécution.